额度与计费
每个账号都带一份计量额度,好让内测的开销可控,也让一次失控的模拟不至于把服务吃光。 这笔钱不会算到你个人头上 —— 额度是配额,用完了来要就是。
两条额度线,不是一条
支出被拆成两个平面,因为它们的行为完全不同:
| 平面 | 付的是什么 | 默认 |
|---|---|---|
| Agent(助手) | 研究助手自己的推理 —— 每一轮对话、每一次写产物 | $10.00 |
| Sim(模拟) | 被模拟世界的成本:跑批时 agent 的 LLM 决策,以及调用外部数据服务 | $10.00 |
用邀请码注册的账号起点更高:$50 + $50。
分开的意义在于:一场很长的设计讨论不会悄悄吃掉你留着跑批的预算,反之亦然。
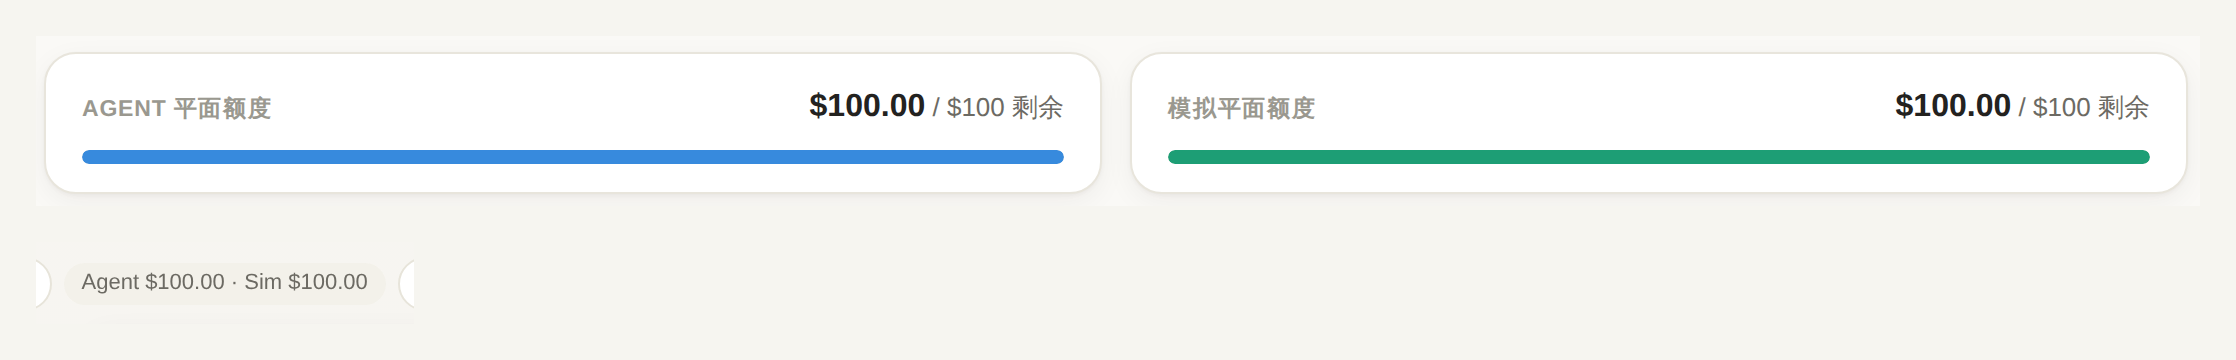
两条余额都以 Agent $x.xx · Sim $y.yy 的形式显示在 study 顶栏,研究列表页则显示成
两张带进度条的卡片。任一平面低于 $1 时,顶栏那个 chip 会变成琥珀色。
什么东西花多少
对话走 agent 平面,按轮计费,与这一轮需要读写多少内容成正比。日常来回很便宜; 从零写一个模型不便宜。
模拟跑批走 sim 平面。成本大致随「人群规模 × 时间跨度」增长 —— 每个 agent、 每一步,都是一次决策。20 个 agent 跑 4 步是几美分;500 个 agent 跑 12 步是另一回事, 这也是为什么助手会在开跑前把配置和预估讲清楚。
外部能力按调用计费:
| 能力 | 怎么算 |
|---|---|
人群问卷模拟(run_user_pool_distribution_simulation) |
按受访人数 —— 每个受访者一份 LLM 问卷作答,所以成本直接随 user_count 线性增长 |
| 人群索引构建 | 一次性固定费用 |
| 事件 / 真实世界数据查询 | 每次调用一笔小额固定费用 |
三者都计入 sim 平面。要特别留神的是按人计费的问卷调用:要 2000 个受访者的花费是 要 20 个的一百倍,而这个数字很容易随手就填大了。
外部调用不是免费查询
人群问卷调用会为每个模拟受访者真的跑一份 LLM 问卷,事件查询会打到真实服务上。 助手必须在调用前把预期花费(包括受访人数)讲清楚并取得你的同意,调用之后对话里 会出现一行记录本次计费。请认真读那几行 —— 它们才是你实际花了多少的真相。
这些服务具体做什么,见 外部能力。
花钱之前你会被问到什么
- 真实跑批之前,你会拿到一次明确的成本确认:配置、预估、以及一张必须回答的提问卡。 用规则(脚本化)决策的 study 不消耗 sim 平面,也就不走这道闸门。
- 调用外部能力之前,助手会说明预期成本并征求同意。
- 每次扣费之后,对话里会出现一行写明工具与金额,顶栏 chip 随之刷新。
盯住累计数
你在会话开头给出的确认,覆盖的是你同意的那件事,它不是一张逐条回执。如果你正在 快速迭代跑好几轮,该看的是顶栏那个余额 chip,而不是你对「我批准过什么」的记忆。
用完了怎么办
agent 平面耗尽时,新消息会被拒绝 —— 对话会提示额度已用尽,请联系团队追加。 已有的 study 和结果不受影响,只是暂时开不了新工作。
sim 平面见底时,助手应当拒绝启动一次它付不起的跑批并告诉你。由于 sim 平面同时 也为外部服务付费,做一次大规模问卷调用之前值得先看一眼 chip。
追加是人工的:找团队说一声,两个平面可以分别提额。
让预算更耐用
- 小规模设计,再放大。 先用 20 个 agent 跑 4 步把环境、人群、指标调对。之后放大 只是改一个参数;而在 500 个 agent 的规模上才发现建模错了,那一课很贵。
- 先干跑,验证管路。 脚本化决策路径能免费把整条循环跑通。等机制没问题了再切到 真实 LLM 决策 —— LLM 接入与干跑 就是干这个的。
- 延长,而不是重来。 当一次迭代只改变第 J 步之后的走向时,热启动会用已存 结果回放前面的步骤,而不是重新付费。见 热启动。
- 问卷要多少人就要多少人。 受访人数是外部成本上最大的那根杠杆。
- 大跑批放本地。 如果一个 study 真的需要成千上万个 agent,把开源包 clone 下来, 用你自己的 key 跑。study 目录是同一份。