对话跑完一个研究
从敲下一个问题到读到一份报告,中间到底发生了什么。阶段就是开源包里的那条
sv-* 工作流,只不过在这里你是靠说话来驱动它。
整体形状
flowchart TD
    Q["你的问题"] --> INIT["sv-init<br/>路由 · 界定 · 锚定"]
    INIT --> MODEL["sv-build-model<br/>(仅从零构建的 study)"]
    MODEL --> ENV["sv-build-environment<br/>E — 层、干预、广播"]
    ENV --> POP["sv-build-population<br/>P — persona,实例化落地"]
    POP --> RUN["sv-run<br/>跑模拟"]
    RUN --> REP["sv-report<br/>结论绑定到数字"]
    REP -.->|"想改点什么"| ITER["sv-iterate<br/>新版本"]
ITER -.-> ENV每个阶段写出一个产物,并在观察面板里对应一张卡。你可以在任何一步停下来看。
1. 说出你想知道什么
一两句话即可。助手会先把它对这个问题的理解讲回给你 —— 人群是谁、随时间变的是什么、 一步代表多久、哪些指标能回答它 —— 并请你确认或纠正,然后才开始构建。
它同时决定怎么建:
| 路由 | 什么时候 | 你会得到 |
|---|---|---|
| 复用 | 已有 study 覆盖了这个问题 | 它的一个 fork,参数改成你的 |
| 从零构建 | 没有匹配的 | 为你的问题新写的模型 —— 这是常见情况 |
| 包装 | 你自带一个已有模拟器 | 你的引擎接到标准接口后面 |
这个阶段一定会跑一次真实世界检索。重要的数字要有来源;实在查不到的会作为 明确声明的假设写下来,而不是悄悄编一个。两者最后都会出现在报告里。
2. 回答确认卡
每个决策点上,助手会在对话里给出一张提问卡:一个问题、几个带解释的选项, 以及一个可以自己写答案的输入框。
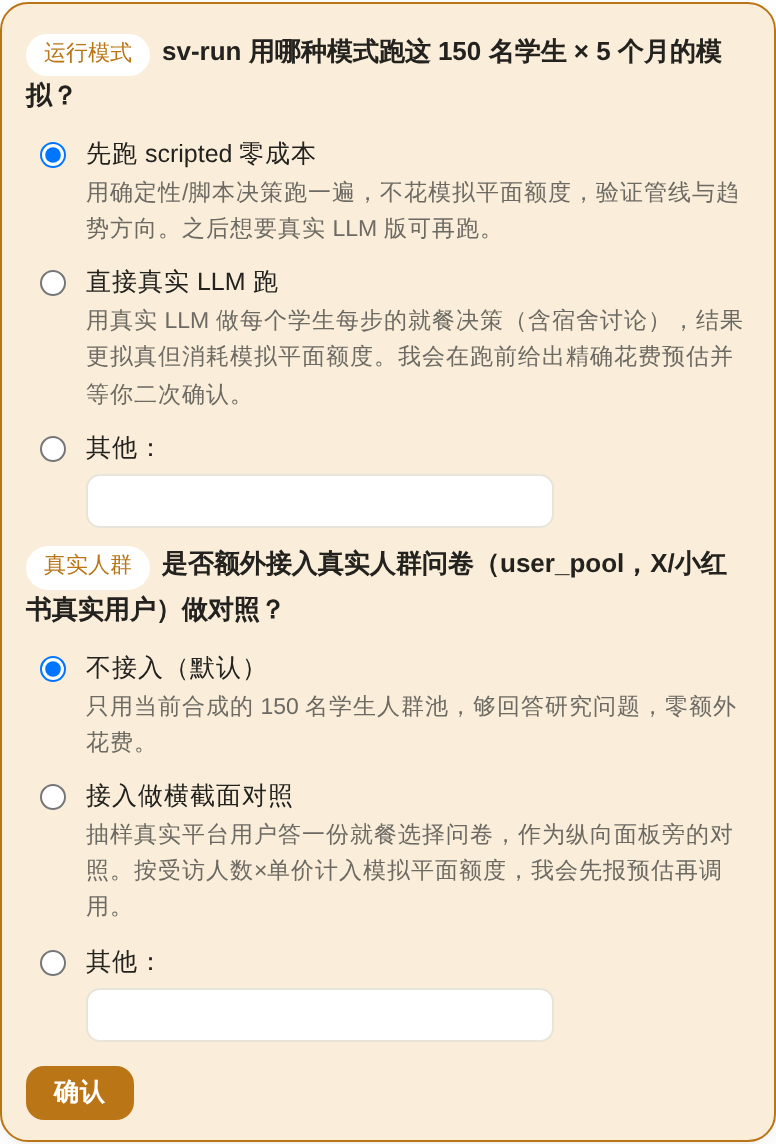
这些卡不是装饰。流程会停下来等你的回答 —— 助手无法越过一张提问卡继续往下走。 已回答的卡片会变灰并保留你的选择,于是「这个 study 为什么长成这样」的理由就留在 对话记录里了。
真实的、要花额度的跑批之前,你一定会先看到一张这样的卡。
3. 看着产物一件件落地
每完成一个阶段,对话里会出现一个阶段 chip,点它会把观察面板滚动到对应卡片。你可以 在产物生成的当下就去读环境的层、人群的构成、跑批的配置 —— 并在花钱跑之前说 「人群再老一点」或者「把干预挪到第 4 步」。
4. 跑批
开跑前,助手会把配置和预估成本讲清楚并请你确认。然后跑批会在前台执行 —— 你能看着步进条前进、指标曲线一点点长出来。
在线版的跑批是被刻意做短的
在线跑批按大约十分钟内跑完来设计。如果你的问题确实需要更大的人群或更长的时间 跨度,助手会在开跑前告诉你,你可以选择缩小规模,或者把这个 study 拿到本地 clone 去跑 —— 目录原封不动就能跑。见 限制与公平使用。
你可以关掉页面。 跑批会在服务器上继续,重新打开这个 study 会回放对话并显示进度。 离开页面不会丢任何东西。
想中断当前这一轮,按 停止 —— 助手工作时,发送按钮会变成停止按钮。
5. 报告
sv-report 写出的报告先给结论,再把结论挣回来:结论速览、轨迹表格与图、每条发现都
与它所依据的具体数字配对、跨指标的深层洞察,最后是数据基础表 —— 每个关键数字
连同它的来源或它被声明为假设的事实。
后续追问就在同一个对话里继续。结果始终可查询,所以跑完之后问「第 2 步到第 3 步之间 哪些 agent 变化最大」是完全合理的。
6. 改点东西,再跑一遍
说出你想要什么不同 —— 更强的干预、更长的跨度、不一样的人群构成。助手会把它做成一个 新版本,保留上一次的结果,于是两者可以画在同一条时间线上对比。
在脚本化跑批和真实 LLM 跑批之间切换永远算新版本:之前那次跑批就是你的对照基线, 覆盖掉它等于毁掉你正想测量的东西。见 迭代、版本与报告。
关于对话,还需要知道几点
- 一个 study 一个对话。 每个 study 有自己的线程和历史,打开就接着上次继续。
- 语言跟随第一句话。 用中文开头,整段对话(包括报告)都会保持中文。
- 对话记录是持久的。 刷新、断线重连、隔一天回来,历史都会回放。
- 服务重启后,未回答的提问卡可能消失。 如果对话看起来停在某个原本有提问的地方, 说一句「继续」,助手会重新问。
- Enter 发送,Shift+Enter 换行。 中文/日文输入法选字过程中的 Enter 只是选词, 不会发送。
- 删除 study 会连同它的对话一起删除。