读懂观察面板
右侧那一栏不是进度条。它就是这个 study 本身 —— 每张卡都由磁盘上的产物渲染而来, 所以你看到的就是跑批真正会用的东西。这一页自上而下把每张卡讲清楚。
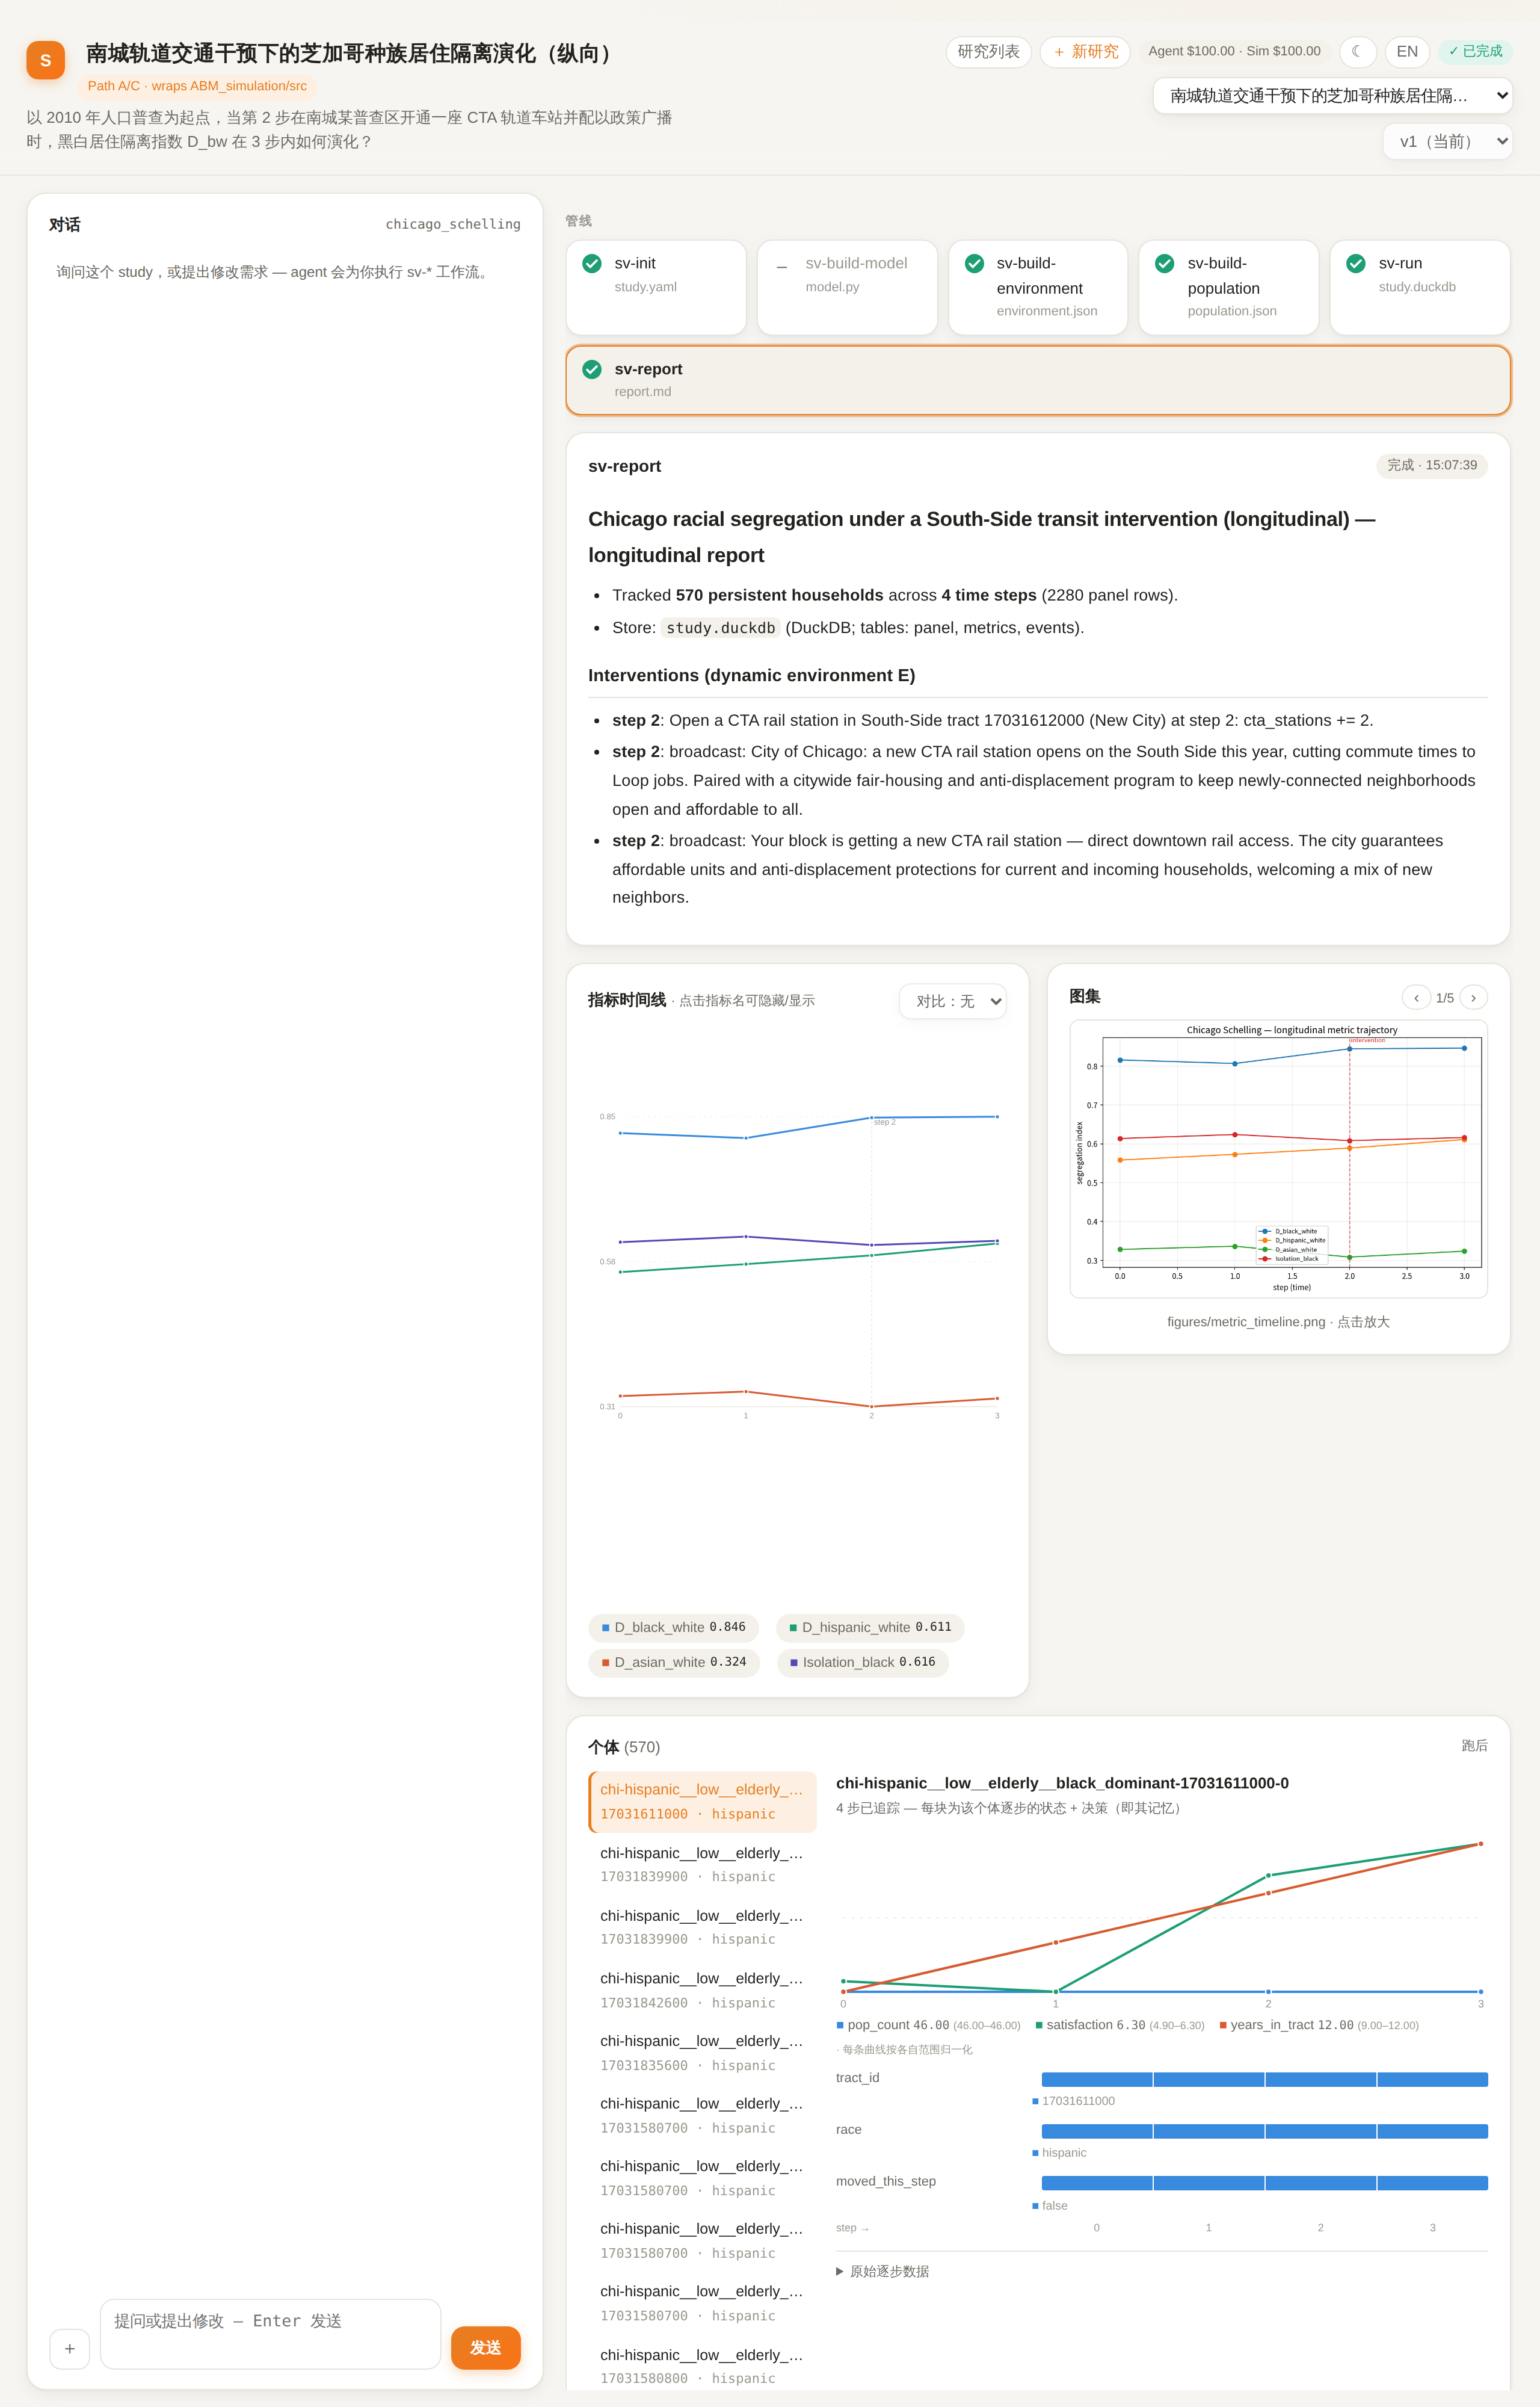
流水线导轨
每个阶段一个 chip:sv-init、sv-build-model(仅从零构建的 study)、
sv-build-environment、sv-build-population、sv-run、sv-report。点击 chip
展开该阶段的详情卡。
chip 的状态是有信息量的:
| 状态 | 它在告诉你什么 |
|---|---|
| done | 这个阶段的产物是最新的 |
| stale | 产物早于它所依赖的上游 —— 需要重跑 |
| 派生 / forked | 这个 study 是从参考 study 派生(study 级 fork)来的,该产物仍来自源头 |
| from v\<n> | 这个版本或分支原样沿用父版本的产物 —— 预期行为,不是警告 |
| 待复核 | 沿用过来、当前版本还没复核的阶段 |
最容易被忽略的是最后一种:迭代之后,即使某个阶段没被改动,也必须被检查过,
整条流水线才算完成。清除这个标记只有两条路 —— 用对应 skill 重做该阶段,或者校验
沿用下来的产物并为本版本补上该阶段的推理说明。助手会二选一,并告诉你选了哪条。
从哪个阶段开始复核,在建版本时就定下了(versions.json 条目里的
resume_from_stage),见版本与可控研究循环。
阶段详情
选中哪个 chip,卡片就展示那个阶段的产物:
- sv-init —— 界定后的问题、时间跨度、每个指标及其一句话含义、以及开场检索得到的 锚定事实。
- sv-build-environment —— 环境的各个层及其 modality/scope/dynamics,以及干预 时间线:每一条干预(定时事件或广播)在第几步触发,广播还带它的受众。在分支 视图下,分叉步之前的干预会灰显并标「继承」—— 它们由父版本重放继承,不在这里重新决策。
- sv-build-population —— 人群规模,以及很关键的构成:persona 在各属性上如何 分布。在为跑批花任何钱之前,你就是在这里确认「人群确实是我想要的那批人」。
- sv-run —— 跑批配置,包括一步在现实中代表多久(
time_unit/step_meaning)。 一条轨迹应该读起来像月或周,而不是一串没有含义的 tick。 - sv-report —— 渲染好的报告。
每张卡还带一段该阶段自己写的推理说明,即助手在做出决定的那个当口对自己的解释。
当跑批不该发生在这里时,会有一条运行提示
有些 study 包装的是重型外部管线(比如需要 GPU 的强化学习训练器),不适合在在线 服务里跑。它们的 run 卡上会带一条运行提示,告诉你 clone 仓库到本地跑,以及 怎么把结果导回来。药品集采 就是这个范例。
指标时间线
study 声明要展示的每个指标一条线,每有一条干预(定时事件或广播)触发就在那一步
打一个标记 —— 标记来自环境包里的 scheduled_events 与 broadcasts。悬停某一步会
同时给出各指标读数和该步的干预说明,于是转折点上直接写着它是被什么打出来的。
- 悬停图例可以看到该指标到底测的是什么、单位是什么、哪个方向算「更多」。
- 点击图例可以隐藏该条线 —— 当某个指标的量纲被别的曲线压扁时,这是最快的读法。
- 跑批期间图表是流式的:曲线一步步长出来,而不是跑完才出现。
- 当版本盒里不止一个节点时,每个节点都带一个对比 / ⇄ 操作。选定基线后,它会以
同色系虚线叠加、分别绘制两个节点的干预标记,并打出一行 Δ 配置 chip 列出差异
——
n_steps、seed、新增(+)或移除(−)的事件与广播、persona 数量。 它只影响这张卡。 - 当被对比的两个节点恰好是一个分支和它分叉自的那个版本时,图例不再写「当前 / 基线」,而是写处理 / 对照。这一对就是配对对照:同一批个体、分叉步之前同一段 被重放的历史,之后只差一条声明过的干预。
图集
报告里的图片,轮播展示 —— 空间型 study 是逐步地图,其它是分布图,另加进入报告的 指标时间线渲染。
Agents
把面板数据变得可检视。列出人群里的每一个 agent;选中一个就能看它的轨迹:
- 每一步的状态,用这个 study 自己的维度表达;
- 每一步的决策;
- 有产出行为时的产出(一条帖子、一份问卷作答、一个选定的去向);
- 以及在 LLM 驱动的 study 里,该 agent 自己的理由 —— 一句话,用被模拟者本人的 口吻,像对同伴解释那样说明它为什么这么选。
最后这一条,是「数字变了」和「数字为什么变,你能读出来」之间的区别。它也是实时的: 面板在跑批过程中就在填充,不必等跑完。
这就是纵向数据的回报
聚合曲线告诉你系统动了。agent 面板告诉你是谁动了、什么时候动的、为什么动 —— 同一批个体,被跨每一步地跟踪下来。这正是把输出变成面板数据、而不是一串快照的 原因。
事件流
这个 study 身上发生过什么的日志:哪个阶段在什么时候产出了什么、每个阶段写下的推理
说明、以及每一个版本或分支的创建(紫色 version chip,带 id 与备注)。
dashboard/server/app.py 里的 build_events() 每次请求都从产物 mtime 加
versions.json 重建它,而版本快照保留了这些 mtime,所以早先的记录不会因为后来某次
迭代重跑了同一阶段而消失。
干预的触发记在跑批那一侧、不在这里:它们落在轨迹存储的 events 表(step、note),
并在上面的指标时间线上显示为标记。
版本与分支
一旦 study 迭代过,版本盒会列出它历史里的每一个节点及其备注。这里住着两类节点, 每个节点上的徽章告诉你它是哪一类:
| 徽章 | 这次改的是什么 | 实际跑了什么 |
|---|---|---|
| 版本 / version | 对研究状态的任何改动 —— 人群 P、行为函数 f、运行设置 Θ,或分叉步之前的某条环境条目 |
从第 0 步开始的冷跑 |
| 分支 / branch | 只在环境里新增了 at_step ≥ t* 的干预,别的一律没动 |
0..t*-1 由父版本已存的动作重放(不调模型),t* 起才真的跑 |
分支会在备注下面写出它的出处 —— 从 v1 · 第 5 步分叉 —— 血缘不用点开就能读。
⚠ 已降级为版本 chip 则是反过来:这个节点是按分支建的,但工作区里的改动超出了环境
范围(动了人群、研究自己的代码、seed,或分叉步之前的干预),不变量检查把它降级了,
于是它按版本冷跑。不报错、不丢东西 —— 只是这个节点不再声称自己是父版本的反事实。
选中旧节点会以只读方式从快照渲染,标记为 归档 · 只读 —— 产物、结果、图,都是
那个节点当时的样子。创建新版本或新分支时视图会自动跳过去,除非你正在刻意查看某个
旧节点。⇄ 把某个节点钉成上面指标时间线的基线;+ 添加干预并分支会把一句写好的
请求塞进对话,助手仍然会对它走一遍版本门。
这个盒子是 study 目录下 versions.json 的渲染:dashboard/server/app.py 的
versions_view() 把每个条目的 kind、fork_step、warm_start.source 与
downgraded_from_branch 以 kind / fork_step / branch_of / downgraded
交给前端。哪些改动够得上分支、以及为什么包装既有模拟器的研究和一步多轮的研究只能
建版本,见迭代:版本与分支。
锚定
这个 study 的数字从哪来:带来源的事实、建模参考、以及明确声明的假设,各自标注为
sourced(实证)、proxy(代理)或 assumed(假设)。同一份账本会被渲染成报告的
最后一节。
三种依据分别意味着什么、以及这个区分为什么是承重的,见 真实世界锚定与溯源。