总览 — 两个循环,一套基础设施
SocioVerse 把一次社会模拟表达成同一个抽象 B = f(P, E),并把它跑成
一套基础设施之上的两个循环:
- 纵向模拟循环让一次运行逐步向前,
E_{t+1} = g(E_t, B_t); - 可控研究循环让研究本身逐次修改向前,
σ_{k+1} = h(a_k, σ_k); - 社科智能体基础设施同时承载两者——编写研究的那组 skill、把 P 与 E 锚定到真实数据的服务,以及让一个做完的研究可审计、可重跑的那批记录。
本页给公式和全景图。两个循环各自还有专页,讲机制、讲实现它的函数、 讲它最终落盘成什么。
flowchart LR
    subgraph INFRA["智能体基础设施 — 工作流 · 服务 · 治理"]
        SIGMA["研究状态<br/>σ<sub>k</sub> = (P, E<sub>0:T</sub>, f, Θ)"]
    end
    SIGMA --> S1
    subgraph LOOP["纵向模拟循环 — 单步 t"]
        S1["① 外生更新<br/>advance_to(t)"] --> S2["② 观察<br/>observe_batch"]
        S2 --> S3["③ 决策<br/>decide_batch = f"]
        S3 --> S4["④ 应用<br/>apply = g"]
        S4 --> S5["⑤ 记录<br/>panel + metrics"]
    end
    S5 -.->|"t + 1"| S1
    S5 --> T[("轨迹<br/>study.duckdb")]
    T -->|"一次修改 a<sub>k</sub> — 分支或版本"| SIGMA
1. B = f(P, E)
这个抽象借自 Kurt Lewin 的场论:行为是人与其环境的函数。它的三项可以 各自独立替换——正因为如此,同一个运行时既能跑 Schelling 隔离模型,也能跑 宏观经济 nowcasting:
- P 可以由普查边缘分布合成、从真实平台用户池抽取,也可以由研究自己构造;
- E 可以锚定在真实事件流上,也可以设计成一个风格化的实验;
- f 可以是经典 ABM 规则、LLM prompt 链、训练好的 RL 策略, 也可以是给不同 agent 群体分派不同实现的混合体。
纵向,而非横截面
AgentSociety、OneSim 这类框架擅长横截面研究:大量单轮实验,且常常每轮 重新抽样一批人。SocioVerse 瞄准的是互补的那个问题——同一批人如何随时间 变化?
这倒转了两个设计选择:
| 横截面 | SocioVerse(纵向) | |
|---|---|---|
| 人群 | 每次实验重新抽样 | 固定池、持久 id |
| 环境 | 每轮基本静态 | 动态——环境才是变化的主体 |
| 输出 | 结果分布 | 面板数据:每个 agent 每步一行 |
持久的 agent id 就是纵向研究的主键:有了它,你才问得出
「把 x-042 这户在全部十二步里的轨迹给我看」,而不只是
「整体发生了什么」。
两轴环境
E 沿两条独立的轴动态展开,让每个 agent 在每一步都拿到一个四象限的世界视图:
| 宏观 | 局部 | |
|---|---|---|
| 物理 | 世界的全局状态 | 该 agent 的邻域状态 |
| 信息 | 所有人都会收到的广播 | 只投递给该 agent 的信息流与消息 |
推动 E 前进的变化有两类,它们在一步里是两次独立的调用:外生变化是
你在环境产物里声明好的时间表(advance_to(t)),内生变化是 agent 自身
行为的反馈(apply(actions))。
2. 纵向模拟循环
在一次运行内部,环境把行为的后果带往下一步:
e_t^i  = ω(E_t, p_i)                 # 该 agent 的四象限观察
b_{i,t} = f(p_i, e_t^i, m_{i,t})     # 在有限记忆窗口下给出的类型化动作
B_t     = { b_{i,t} }_{i=1..N}
E_{t+1} = g(E_t, B_t)
第 0 步在声明的 seed 下实例化 P、构建 E_0、记录初始面板行,不做任何决策。
此后每一步都跑同样的五个阶段,顺序固定,由
socioverse/engine/loop.py 里的
LongitudinalSimulator.run() 实现:
| 阶段 | run() 里的调用 |
做什么 |
|---|---|---|
| ① 外生更新 | env.advance_to(t) |
触发排在 t 上的事件与广播 |
| ② 观察 | env.observe_batch(ids, t, r) |
把 E_t 投影到每个 agent(模态 × 范围) |
| ③ 决策 | decision.decide_batch(obs, memories) |
算出 B_t = f(P, E_t, memory),每个 agent 一条类型化动作 |
| ④ 应用 | env.apply(actions) |
把行为折回环境:E_{t+1} = g(E_t, B_t) |
| ⑤ 记录 | store.record(...) + 记忆入队 |
每个 agent 一行面板、一行指标,以及本步触发的事件 |
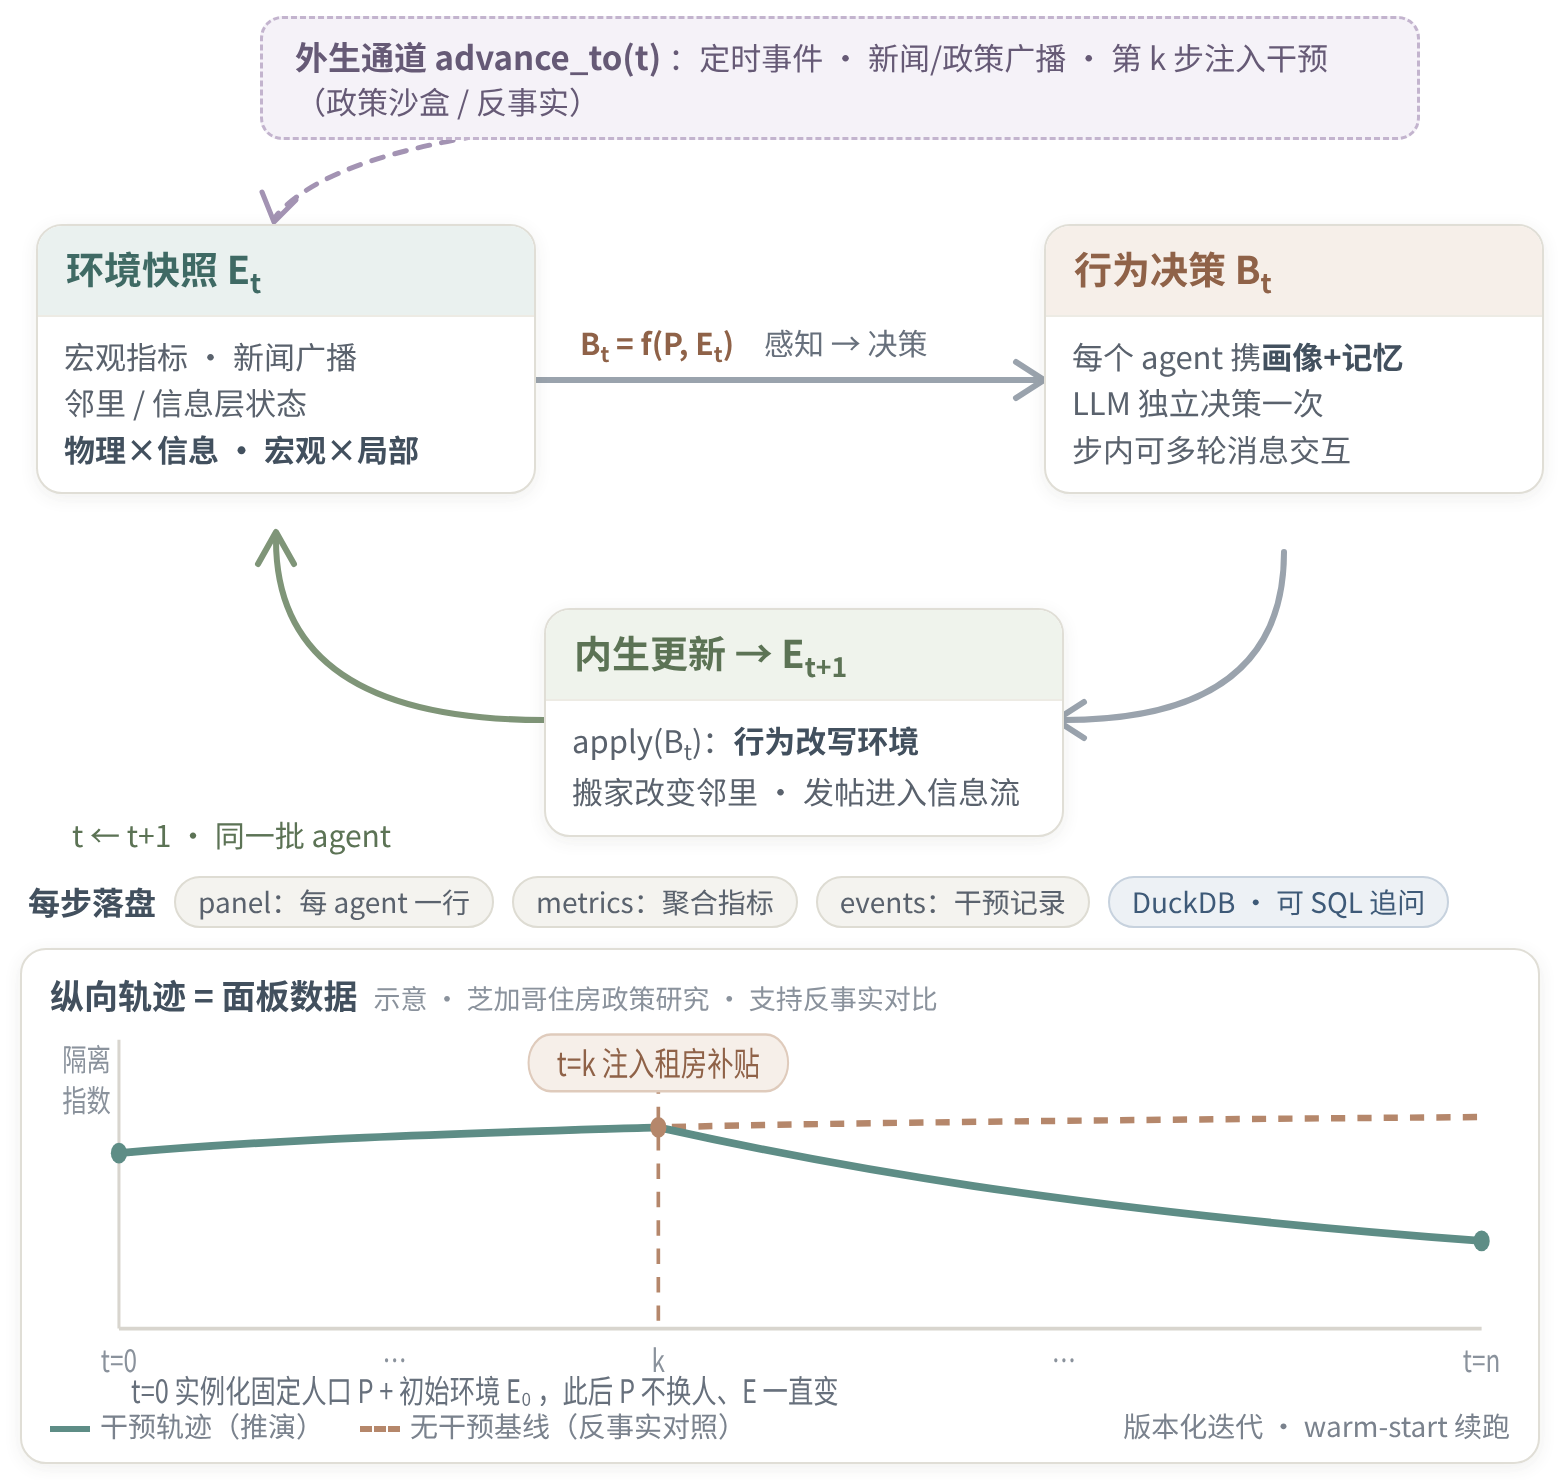
这个顺序有三条性质是刻意为之的:
- 干预在阶段 ① 进入,早于任何人观察,所以同一轮里每个 agent 面对的是同一个状态。
- 决策按步进行。
decide_batch一次拿到整步的全部观察,为每个 agent 返回 一条行为,所以同一步里每个 agent 都面对同一个E_t。内部怎么调用 LLM 由模型决定: 从零构建的研究为每个 agent 各发一次调用、并发执行;遗留适配器保留其引擎自己的方式 (调用方式)。 - 每一步边产生边记录。 由于
apply是已记录动作的函数,一次运行可以 完全不带决策模型、只凭存下来的行重新执行一遍——这正是分支所继承的东西。
→ 模拟循环 —— 逐阶段细节、类型化交接
(Persona[] → Observation[] → Action[] → metrics,全部是
socioverse/schemas/ 里的 Pydantic 模型)、记忆窗口,以及 DuckDB 表结构。
3. 可控研究循环
一个纵向研究很少只有一次运行。研究本身就是一个你会去改的对象。把 研究状态记作
一次修改 a_k = (c, u) 指明它触及哪些组件 c ⊆ {P, E, f, Θ}、以及施加
的更新 u。研究者和 agent 都可以提出它,由 h 施加后得到下一个版本。h 只有
三种情况:
c |
结果 | 实际跑什么 | 代码里 |
|---|---|---|---|
| ∅ | 不变 | 什么都不跑 | 当前版本仍是当前版本 |
分叉步 t* 之后的 {E} |
分支(branch) | 0..t*-1 由父版本已存的动作重放(无 LLM、不计费),只计算 t*..T |
create_branch(study_dir, note, fork_step=…) |
| 其它任何改动 | 版本(version) | 从第 0 步冷跑 | create_version(study_dir, note, …) |
两者都在 skills/sv_workspace.py 里,都会往研究的 versions.json 清单追加
一条记录,含 id、parent、note、kind("branch" 或 "version")、
fork_step,以及重新进入流水线的阶段。建版本时会先把整个 live 工作区冻结进
versions/v<k>/,所以每个更早的版本都还能查、还能重跑。
分支要拿到重放这份优惠,前提是除了分叉步之后的环境以外什么都没变。
check_branch_invariant() 在开跑前做这项校验;一旦违约,它会把分支降级为
版本而不是报错退出:这次运行从第 0 步冷跑,结果依然正确,降级原因写进清单
条目里留痕。
这里的 fork 是另一回事
在本文档中,fork(派生)只保留给 study 这一层:/sv-init 会把一个
匹配上的参考研究派生成你自己的新研究(Path A)。在一个研究内部,你创建的
是分支与版本,不存在 fork。
→ 研究循环 —— 版本门、清单字段,以及如何对比版本。
→ 干预与分支 —— 一条 ScheduledEvent 或
Broadcast 声明了什么、重放如何逐步复现父版本,以及怎样从两条分支上读出
Δ_t(δ)。
4. 社科智能体基础设施
两个循环跑在同一套基础设施上,它分三层组织。
| 层 | 做什么 | 在哪里 |
|---|---|---|
| 工作流层 | 把研究生命周期拆成 skill;每个 skill 读前序产物、只写一份经校验的产物,然后停在检查点 | .claude/skills/ —— sv-init、sv-build-model、sv-build-environment、sv-build-population、sv-run、sv-report(外加 sv-lit / sv-paper)、sv-iterate |
| 服务层 | 在构建期把 P 与 E 解析到真实世界数据上,形式是类型化的 MCP 工具,而不是把数据集拷进研究目录 | 人群池服务(sv-user-pool)与事件信号服务(sv-event-tool) |
| 治理层 | 记录每个阶段做了什么、用了哪些数据、你批准了什么 | grounding/grounding.json、resources.json、versions.json,以及 trajectory/study.duckdb 里的 events 表 |
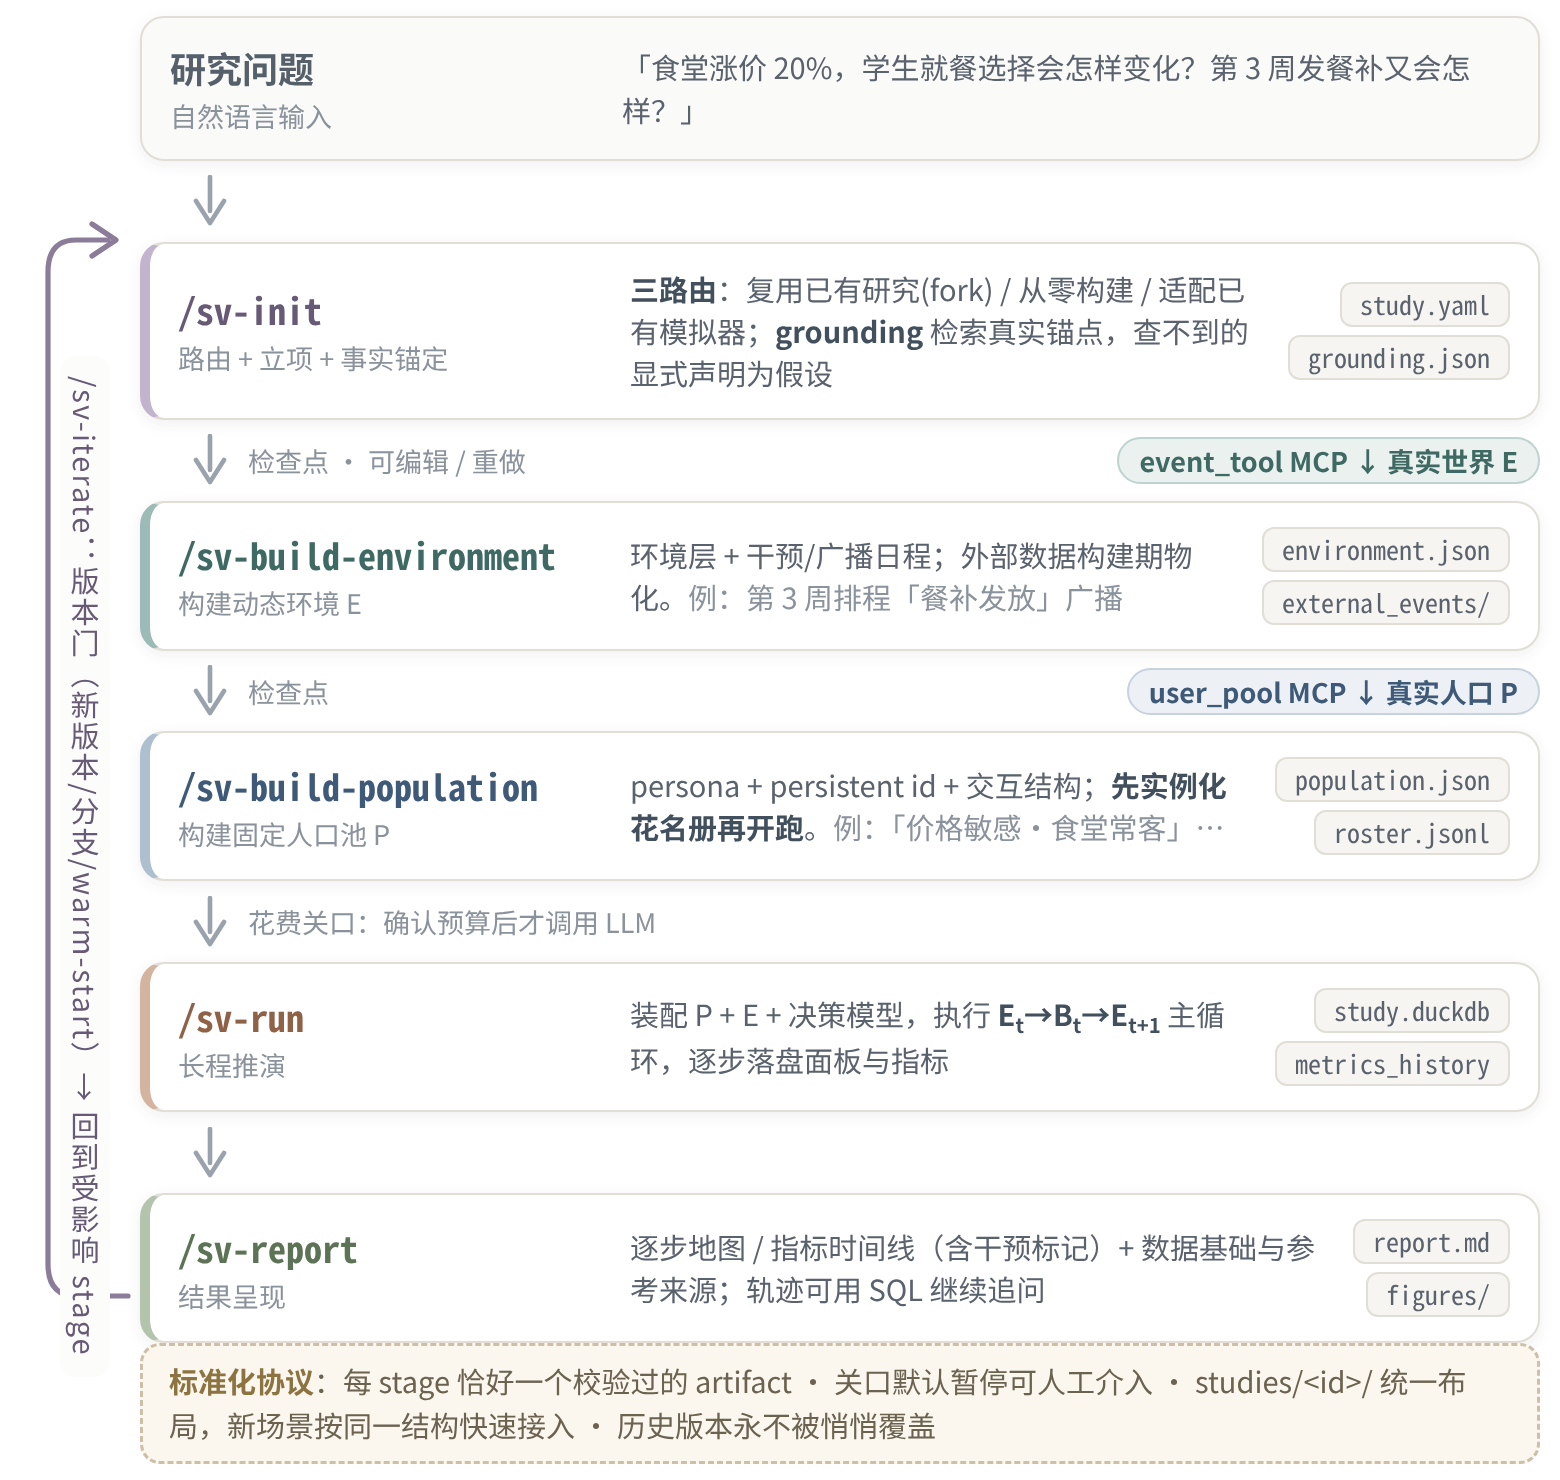
有两条后果值得直说:
- 运行时不取任何外部数据。 服务只在研究被构建的时候调用,结果被物化进 环境包与人群包。因此一次运行是自包含、可重复的。
- 承重的数值必须引用来源。 每个研究都带一份 grounding 侧车
(
grounding/grounding.json),存放有来源的事实、建模参考,以及显式声明 的假设。无法溯源的东西被声明出来,而不是悄悄编造。
→ 数据服务 —— 两个 MCP 服务,以及它们各自物化 出什么。 → 真实世界锚定与溯源 —— 侧车的 字段,以及各构建阶段如何扩充它。
概念在代码中的位置
| 公式里的符号 | 代码里 |
|---|---|
P —— 固定人群 |
socioverse/abc/population.py(PopulationProvider.build(seed));产物 population/population.json + population/roster.jsonl |
E —— 动态环境 |
socioverse/abc/environment.py,可复用层在 socioverse/env_layers/;产物 environment/environment.json |
f —— 行为函数 |
socioverse/abc/decision.py(DecisionModel.decide_batch) |
g —— 环境更新 |
EnvironmentProvider.apply(actions) |
ω —— 观察算子 |
EnvironmentProvider.observe_batch(ids, t, round) |
m —— 记忆窗口 |
socioverse/engine/memory.py(AgentMemory,默认 8 步) |
B_t —— 本步的行为 |
socioverse/schemas/runtime.py 里的 Action;panel 表的 action_kind / action_payload |
Θ —— 运行设置 |
simulation/simulation.json(seed、n_steps、interaction_rounds,以及 *_ref / *_args 绑定)+ resources.json |
| 模拟循环 | socioverse/engine/loop.py(LongitudinalSimulator.run) |
| 轨迹 | socioverse/io/duckdb_store.py → trajectory/study.duckdb(panel / metrics / events / messages) |
| σ 与它的各个版本 | versions.json + skills/sv_workspace.py(create_version、create_branch、check_branch_invariant) |
| 类型化契约 | socioverse/schemas/ —— 每个阶段边界上写时校验、读时也校验 |
下一篇:一个 Study 的解剖 —— studies/<id>/ 里有什么。