HiSim ROE —— 同一个内核上的 LLM + ABM 混合人群
studies/hisim_roe/ · reference: true · Path B(在核心内核上从零构建)
在一个 Twitter 式平台上,当「最高法院推翻 Roe v. Wade」这条新闻触发之后, 由 LLM 驱动的核心用户与由 ABM 驱动的普通用户,各自的态度如何演化—— 以及,真正推动宏观舆论的是哪一群人?
这个案例是混合人群(hybrid population)的样板:两个 cohort 共享同一个 环境、同一份面板、同一套指标,却跑着完全不同的行为函数 f。它同时也是把一个 外部模拟器(HiSim)原生移植到核心接口上、而不是包装它的样板。
P / E / B
| 是什么 | 来自哪里 | |
|---|---|---|
| P | 20 个 agent:8 个 core-*(LLM 角色扮演)+ 12 个 ord-*(有界信心规则)。态度按 [-1, 1] 均匀初始化,在 seed: 42 下确定可复现。交互结构为 explicit_network——一个只覆盖核心用户的 16 条有向边环;propagation 为 contagion。 |
population/population.json(materialized_count: 20) |
| E | 3 个层、1 个 scheduled event、1 条 broadcast(见下表)。provider 为 hisim.twitter_env:n_core: 8、n_ord: 12、alpha: 0.3、bc_bound: 0.1、target: "the protection of Abortion Rights"。 |
environment/environment.json |
| B | decision hisim.hybrid_decision(mode: llm、gpt-4o-mini)。核心用户角色扮演并行动,其态度随后由所发推文「镜像」回写;普通用户跑 Deffuant 规则。 |
model.py |
| layer | modality | scope | dynamics | 内容 |
|---|---|---|---|---|
tweet_feed |
information | local | endogenous | 受众时间线上的近期推文 |
trigger_news |
information | macro | scheduled | 线下事件新闻广播 |
peer_opinion |
physical | macro | endogenous | 全局信心带内的同伴态度(BCM) |
第 2 步:一个 scheduled event 写入 trigger_news.content,同时广播 N1
("News- a major event concerning the protection of Abortion Rights occurs.")
以 audience: "all"、ttl 4 发出。
两条行为分支的确切形态:
- 核心(LLM) —— 每个核心用户每步一次角色扮演调用,产出一个 action 与一个
stance;该 agent 的态度被重写为
sign(stance) · |sentiment|。全程观察到的 action kind:retweet18 次、post10 次、like2 次、do_nothing2 次。 - 普通(ABM) —— Deffuant 有界信心更新
new = x + alpha · (peer − x), 仅在|peer − x| < bc_bound时生效(alpha0.3、bc_bound0.1)。全程 48 次update_opinion,即 12 人 × 4 个决策步。
LLM 分支是方差注入源(态度可以跳变,甚至反号);规则分支是收缩算子 (只会把邻居拉近)。谁占上风是个经验问题——本研究给出了答案。
一步是什么,跑多久
一步 = 平台上的一个回合:核心用户看到自己的时间线与仍然生效的广播并行动,
普通用户向信心带内的同伴同化,随后在全部 20 个 agent 上计算指标。
n_steps: 4、seed: 42,因此共 5 行指标(t=0 + 4 个决策步)。
本研究每步只跑一轮交互
仓库里的 simulation/simulation.json 是 interaction_rounds: 1——尽管
study 的 demonstrates 字段提到了 multi-round messaging。交付与实际运行
的都是单轮。 若你想在一步之内做多次消息往返,那是一处配置改动,见
多轮交互。
结果
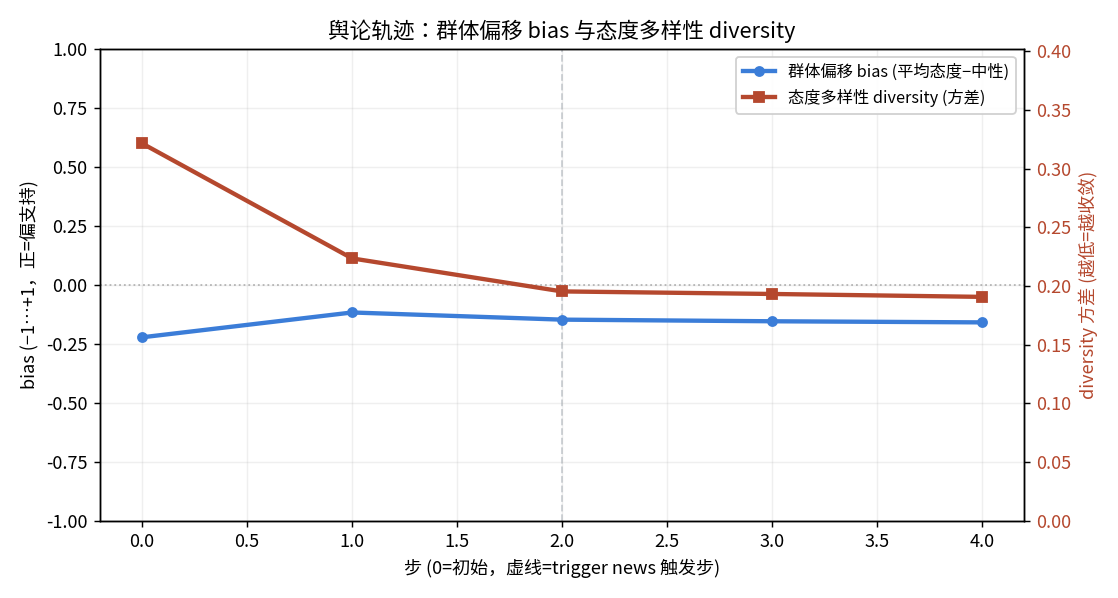
| step | bias |
diversity |
mean_core |
mean_ordinary |
n_active |
n_post |
|---|---|---|---|---|---|---|
| 0 | -0.2223 | 0.32156 | -0.1112 | -0.2964 | 0 | 0 |
| 1 | -0.1170 | 0.22357 | +0.1559 | -0.2990 | 6 | 6 |
| 2(news) | -0.1474 | 0.19541 | +0.0885 | -0.3047 | 8 | 7 |
| 3 | -0.1543 | 0.19324 | +0.0749 | -0.3070 | 8 | 7 |
| 4 | -0.1590 | 0.19076 | +0.0653 | -0.3085 | 8 | 8 |
全程净变化:bias +0.0633、diversity −0.1308(群体收敛)。两个 cohort
明显分道:核心用户移动 +0.1765,而普通用户只移动了 −0.0121。
真正有启发的细节是移动发生在什么时候。bias 全程最大的单步变化是第 1 步的
+0.1053——发生在新闻触发之前。而新闻那一步本身只让 bias 变动
−0.0304;核心活跃数在第 1 步就已有 6/8,第 2 步才满格 8/8。在这个规模下,
主导宏观曲线的是 LLM cohort 自身的表达,而不是外生冲击:议题从一开始就在核心
用户的 prompt 里,他们立即开始表态,一次性新闻只是叠加在已经很高的活跃度之上,
边际效应很小。
第二条读数是它的镜像:高活跃度不等于大幅移动。核心活跃度从第 2 步起就满格,
但 bias 从第 2 步到第 4 步几乎横盘——因为 8 个核心态度正负相消,而 12 个普通
用户(占面板 60%,期末 -0.3085)几乎不动,把宏观 bias 牢牢锚在其初始水平附近。
Grounding
4 条 sourced 事实、3 条声明的假设、2 条建模参考。
| 条目 | basis | 作用 |
|---|---|---|
| Dobbs v. Jackson 于 2022-06-24 推翻 Roe(SCOTUSblog) | sourced |
trigger_news 所代表的真实外生冲击 |
| Pew:判决前约 61% 认为堕胎在全部/多数情形下应合法 | sourced |
均匀初始化刻意不去使用的真实先验 |
| Pew 判决后:57% 反对 / 41% 支持,n = 6,174 | sourced |
demo 的 bias 不可被读作在预测的那个净态度 |
HiSim 官方 ROE 配置:1000 个普通 agent、alpha 0.3、14 回合 |
sourced |
本展示所缩减自的参考规模 |
| 用 8 核心 + 12 普通 × 4 步,替代 1000 × 14 | assumed |
以 demo 成本跑通完整真实 LLM 路径;这些数量本身就是 adjustable_params |
| 均匀 [-1, 1] 初始态度,而非 Pew 偏斜先验 | assumed |
HiSim 真实 ROE 用户数据未随仓库分发,真实数据路径跑不了 |
| att 镜像中用 TextBlob polarity 充当情感函数 | assumed |
轻量替身,忠于「符号 × 强度」的镜像形状 |
建模参考:Mou et al. (2024),Unveiling the Truth and Facilitating Change (HiSim,ACL 2024 Findings)——本研究所移植的论文;以及 Deffuant, Neau, Amblard & Weisbuch (2000),Mixing beliefs among interacting agents —— 普通 cohort 背后的有界信心规则。
因为初始态度是均匀的而非按 Pew 校准的,bias 的绝对水平不承载任何民调
主张。可迁移的是相对机制:cohort 分道、diversity 的收敛、以及冲击的时序。
可以 fork 什么
| 参数 | 它打开的问题 |
|---|---|
n_core / n_ord |
8 : 12 时 LLM cohort 占上风。把比例推向 HiSim 的 1000 个普通用户,沉默多数应当重新夺回主导权——交叉点出现在哪个配比? |
alpha |
沉默多数同化的快慢,也就是这个锚有多「硬」。 |
bc_bound |
0.1 偏窄。扫到 ~0.5 可看到经典的有界信心相变(分裂→共识),并检验 LLM cohort 是否移动了临界点。 |
| news schedule | 把新闻挪到第 1 步,或加第二波冲击,检验在议题尚未饱和时 bias 是否出现真正的二次拐点。 |
target |
同一套混合机制,换一个议题。 |
报告自己给出的第一条建议是做一次 parity fork:用确定性的 scripted 决策替换 LLM 跑同一个研究,量化角色扮演相对规则桩是否引入系统性偏移。以这种方式从零 构建的结构与机制,见从零构建 Study(Path B)。