消费者信心 —— 当纵向轴是「信息」而不是「时间」
studies/consumer_confidence/ · reference: true · Path C(包装
ConsumerSim 管线)
给定一个固定人群池和某一时点可得的新闻,能否预测该月的美国消费者信心?
以及——当信息在同一个目标月内不断累积时,预测如何随之更新?后半句才是
这个案例值得抄的地方:面板的纵向轴不是日历时间,而是 as_of 信息截止日。
每一步都用一个严格更大、且点时安全(point-in-time safe)的信息集,对同一个
目标月重新预测一次。这是把一个天生「单发」的模拟器,改造成一个诚实的纵向
故事的通用手法。
P / E / B
| 是什么 | 来自哪里 | |
|---|---|---|
| P | 12 个合成分层 persona,us-demo-0001 … us-demo-0012,每人占据 region × age × income × education × location 的一个互异格。interaction: none、propagation independent——受访者之间互不交谈,这对调查工具而言是正确的。 |
population/population.json(materialized_count: 12) |
| E | 只有两层,且没有 scheduled events、没有 broadcasts(见下表)。provider 为 consumersim.env:region: US、3 个 target_months(都是 2026-06)、3 个 as_of_dates。 |
environment/environment.json |
| B | decision consumersim.decision:被抽中的 core agent 产出 kind 为 survey_response 的 Action,用 positive / neutral / negative 回答 5 个 UMich 式问题。非核心 agent 产出 not_sampled,随后被贝叶斯扩展改写为 expanded_response。 |
adapter/decision.py、adapter/providers.py |
| layer | modality | scope | dynamics | 内容 |
|---|---|---|---|---|
consumer_information |
information | macro | scheduled | 目标月的点时新闻 + 指标快照,随 as_of 推进每步重建 |
consumer_demographics |
physical | local | static | ConsumerSim 所消费的固定人群人口学属性 |
没有事件的环境,依然是动态环境
scheduled_events 与 broadcasts 都是空的。E 仍然每步都在变——因为信息层
是按新的 as_of 截止日重建的。动态性并不要求有一次干预。
设计的另一半是 core / expansion 切分。core_ratio: 0.5 意味着每步由 LLM 直接
预测的是 12 人中的 6 人;另外 6 人由分层贝叶斯小域模型,从核心样本的群体
后验扩展得到。三步下来,覆盖整个人群池只花了 18 次模拟层 LLM 调用。
一步是什么,跑多久
一步 = 同一目标月内的一个 as_of 截止日:同样这 12 个 agent,面对「该日期
及之前发布的一切」被重新调查一次。n_steps: 3、seed: 42、
interaction_rounds: 1。
| step | as_of |
目标月 |
|---|---|---|
| 1 | 2026-06-13 | 2026-06 |
| 2 | 2026-06-20 | 2026-06 |
| 3 | 2026-07-01 | 2026-06 |
step 0 是一行空的热身记录(无 as_of、无分数)——人群已存在,但尚未预测。
结果
| step | as_of |
raw_score |
corrected_score |
news_count |
|---|---|---|---|---|
| 0 | — | — | — | 0 |
| 1 | 2026-06-13 | 128.33 | 129.83 | 4 |
| 2 | 2026-06-20 | 138.33 | 139.83 | 5 |
| 3 | 2026-07-01 | 121.67 | 123.17 | 10 |
population_size 恒为 12、core_size 恒为 6——面板确实是固定的,变的只有信息。
预测走出一条「倒 V」:它跟随信息环境,而不是随时间漂移。combined_score 为
0.0563 → 0.0900 → 0.0675,修正后总分与之同形。注意新闻数量单调上升
(4 → 5 → 10),而净情绪在中间那个截止日见顶,随后被更晚、更混杂的标题稀释。
新闻更多 ≠ 情绪更好——这正是点时安全信息集要让你看见的东西。
报告自己写明的两条 caveat
indicator_count每步都是 0:随附的指标观测日期晚于各步as_of截止日,被点时过滤器正确地滤掉了。因此combined_score全靠新闻情绪撑着。- 绝对水平(~120–140)未经校准。同月经过 grounding 的真实读数是 Conference Board CCI 91.2、UMich ICS 44.8。这个模板要读的是 「信息累积下的方向」与分项结构,而不是绝对点位。
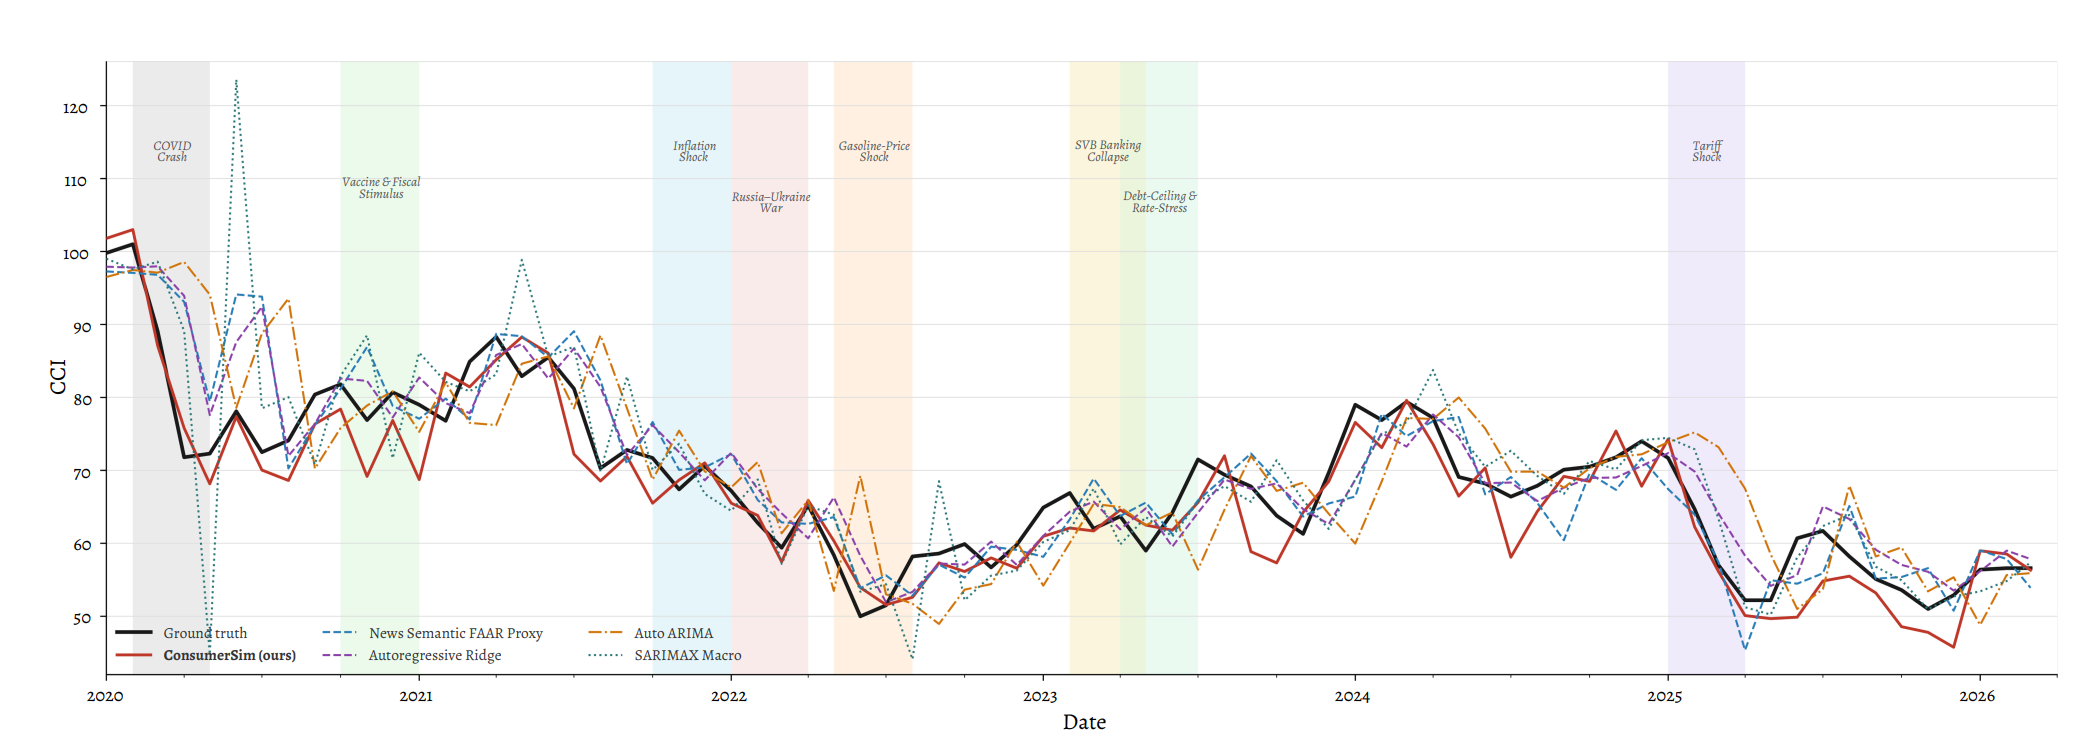
被包装的引擎在完整规模下是另一幅图景。下面是 ConsumerSim 自己的 2020–2026 历史回测(来自外部管线,不是这个 12 人 study):逐月 CCI 预测对照真实值与 经典基线,跨过 COVID、通胀冲击与 2025 年的关税冲击:
Grounding
5 条 sourced 事实、3 条声明的假设、2 条建模参考。
| 条目 | basis | 作用 |
|---|---|---|
| Conference Board CCI 2026-06 = 91.2(1985=100) | sourced |
本研究输出明确不去对标的水平线 |
| 其分项:Present Situation 116.4、Expectations 74.4 | sourced |
实证上的「当期弱 / 远期强」分裂 |
| UMich ICS 2026-06 = 44.8(FRED,经 SocioVerse Event 服务) | sourced |
第二套量纲,用于看方向 |
| UMich 2026-07 = 54.4,五个分项全部改善 | sourced |
可用于样本外检验的后续走势 |
| 宏观背景:CPI 同比 +3.9%、失业率 4.2%、汽油 $3.831/加仑 | sourced |
6 月新闻快照背后的驱动因素 |
展示运行把 core_ratio 调高于管线默认值 |
assumed |
用默认值时,12 格人群池的分层核心会塌缩成 1 人 |
把纵向轴解读为 as_of 信息累积 |
assumed |
对手上已有数据的可辩护用法,而非编造未来月份 |
| 把输出视为 Conference-Board 式指数量纲 | assumed |
由管线自身的修正锚点推断得到,上游文档未明述 |
建模参考:Statistics Canada(Survey Methodology, 2002)关于多项式小域数据的 分层贝叶斯不可忽略无响应模型——core → expansion 设计的依据;以及密歇根大学 Surveys of Consumers 方法论——决策模型所回答的五问题骨架。
最后那条假设值得细读:量纲映射是从数据文件推断出来的,所以它被声明为
assumption 而非引用来源。sourced / proxy / assumed 各自的承诺见
真实世界锚定与溯源。
可以 fork 什么
| 参数 | 它打开的问题 |
|---|---|
region |
同一套信息集,作用在不同区域的人群池上会同向移动吗? |
target_months |
等 7 月新闻齐备后加一步 2026-07,检验 grounding 里记录的回升到 54.4。 |
as_of_dates |
更密的截止日会把「倒 V」变成一条真正的信息累积曲线。 |
| news / indicator / history 输入 | 抽掉利好油价新闻做反事实:6 月预测里有多少来自「油价叙事」?或换入截止日之前的指标,让 indicator_count 不再为 0。 |
core_ratio |
在 LLM 预算与扩展方差之间取舍;n=12 时单个核心样本的翻转就能撬动头条分。 |
| prediction provider | 换掉回答调查问题的模型,直接 diff 两条轨迹。 |
最自然的第一个 fork 是规模:更大的人群池配更低的 core_ratio,可以在 LLM
预算不变的前提下平滑头条分。复用永远是 fork 而非原地修改——见
迭代、版本与报告。