ABM Sugarscape —— LLM 的 f 能复现规则的 f 吗?
studies/abm_sugarscape/ · 不是 reference study · 套在同级
SocioVerse-ABM 基准之上的 umbrella 壳
在一片高低不平的糖田上觅食,会不会产生财富不平等;换成 LLM agent,它能复现
这一现象吗?Sugarscape 是十一个 abm_* study 家族的示范样本,而这一家族
存在的理由只有一个问题:把规则行为函数换成 LLM 行为函数,保持 P 与 E 不变,
看宏观模式还在不在。
这一页刻意是本组里最薄的一页——因为那个 study 目录,本来就刻意是 studies/
里最薄的东西。
这里究竟有什么
studies/abm_sugarscape/ 只有两个文件:一份 18 行的 study.yaml,和一个
__init__.py,其 make_bundles() 直接委托给
studies/_abm_common/make_abm_bundles("sugarscape", …)。共享的 umbrella 机制
住在 studies/_abm_common/;任务本体——网格、agent、rule_f、llm_f、
评测——住在同级仓库的 SocioVerse-ABM/tasks/market/sugarscape/。
需要同级检出
umbrella 通过 $SV_ABM_ROOT 定位 SocioVerse-ABM,否则退回到 beta 仓库的
同级目录。没有它就什么都跑不了——而 tests/test_abm_sugarscape.py 会
skip 而不是 fail,与 Chicago 研究在缺少普查数据时的约定一致。
P / E / B
| 是什么 | |
|---|---|
| P | 50×50 环面网格上的 200 个 citizen,id 为 sugarscape-0000 …,代谢率取自 1–4、视野取自 1–6、初始糖量取自 5–25。interaction: none。agent 会饿死并离开网格;beta 的 persona 池保持固定,umbrella 对已离场的 agent 返回一个空 Observation。 |
| E | 糖景观:patch 容量上限 4,每步再生速率 1。 |
| B | 只有一种 action kind:move。mode 为 rule | llm | hybrid,默认 rule。 |
LLM 分支值得看一眼,因为它窄得刻意:agent 只被展示自己当前的糖量,以及一个 带编号的可达格菜单(每格标注糖量与距离),然后只返回一个下标。整个接口就 这么多。这场比较完全不依赖 LLM 写出漂亮的散文——它是从规则函数所面对的同一个 候选集里挑选,这正是比较能干净成立的原因。
指标:alive、mean_sugar、gini。没有 metric_descriptions,也没有
display_metrics——又一个说明 umbrella 壳应当有多简的信号。
一步是什么,跑多久
一步 = 一轮觅食与代谢:每个存活 citizen 移动到一个可达格、收割它、支付自己的
代谢,然后 patch 再生。study.yaml 里 n_steps: 30、seed: 42。
umbrella provider 的 advance_to() 返回 [] —— 完全没有任何干预,本研究
如此,它的十个同族亦然。这不是遗漏,而是设计:一个要检验「一个 f 能否复现另一个
f」的基准,绝不能让外生冲击来混淆这场比较。
结果
没有提交结果、没有 grounding 侧车、没有报告
本研究以纯结构交付。没有 trajectory/、没有 reports/、没有
grounding/——要拿到数字,得自己对着同级检出跑一次。
关于它行为的全部断言,只存在于 tests/test_abm_sugarscape.py:
| 断言 | 它钉住了什么 |
|---|---|
n_steps=30 得到 31 行指标 |
t=0 基线 + 每步一行 |
末步 alive < 首步 alive |
citizen 确实会饿死;离场 agent 路径被真正走过 |
末步 gini 落在 [0, 1] |
不平等指标形式正确 |
与原生 SocioVerse-ABM 轨迹在 alive、mean_sugar、gini 上逐步完全一致 |
umbrella 是忠实的再托管,不是重新实现 |
最后那条测试才是本页真正的内容。parity 是精确相等而非近似:因为两侧的活跃
agent 集合与行动顺序完全一致(按 agent id 排序、同一 seed)。它的含义是——
你之后在 mode: rule 与 mode: llm 之间观察到的任何差异,都只能归因于行为
函数,而不是栈里的其它任何东西。
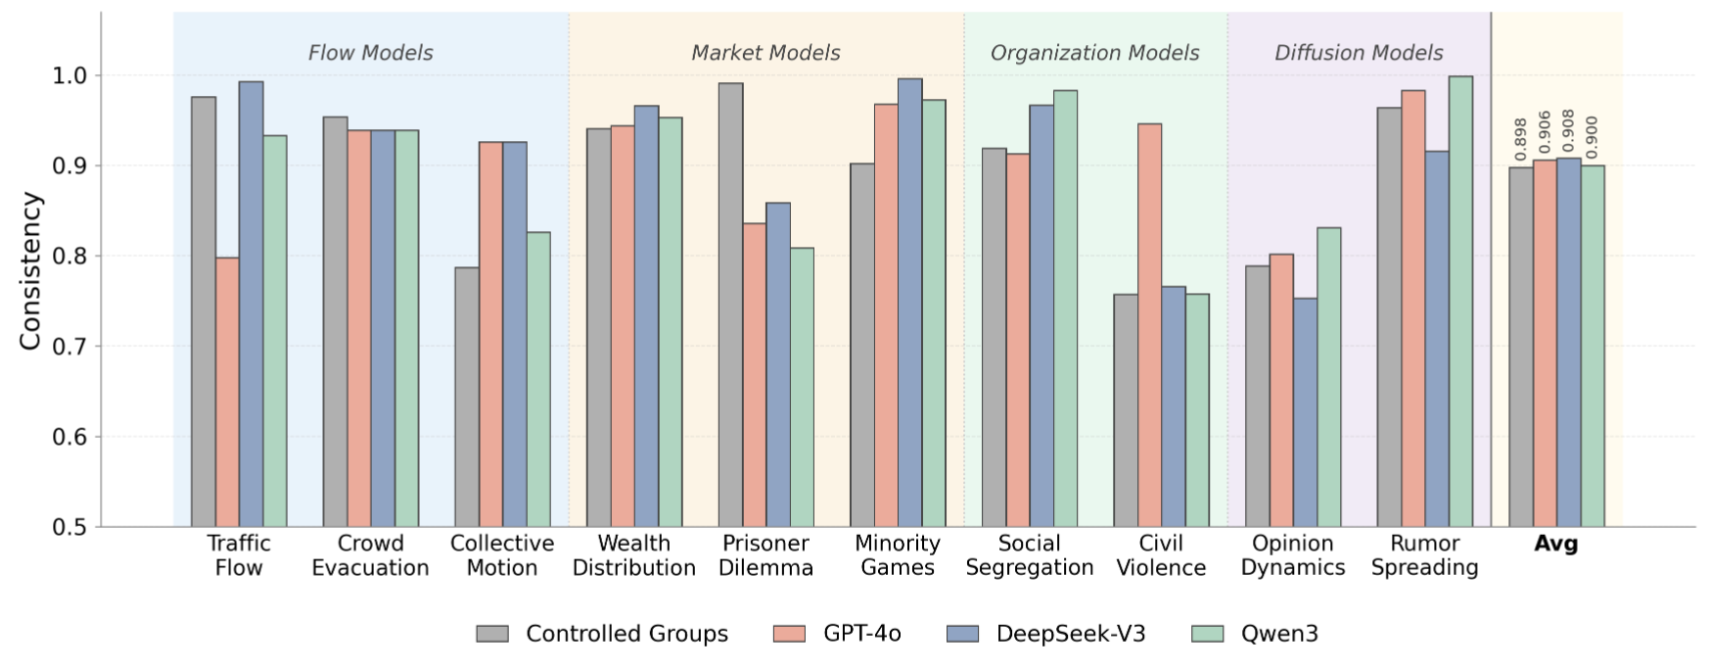
而这个命题在 sugarscape 之外同样成立。放到整个 SocioVerse-ABM 基准 —— 本家族对应的 11 个经典模型 —— 上看,LLM 行为函数复现规则动力学的平均一致性约 0.90,且在各模型家族之间、以及 GPT-4o / DeepSeek-V3 / Qwen3 之间都相当均匀:
Grounding
这里没有 grounding/grounding.json,而这是自洽的、不是偷懒:一个基准研究并没有
对真实世界提出主张。它的参数就是该任务公开的默认值,它的有效性主张是内部的
——对照原实现的 parity,由 CI 里的测试来强制,而不是由台账里的一条引用来担保。
对照另外几页的研究型案例:那里侧车的全部意义在于,任何承重的、关于真实世界的 数值都必须引用一条事实或声明一条假设。什么时候侧车在真正干活、什么时候它只是 仪式,见真实世界锚定与溯源。
可以 fork 什么
来自 study.yaml 的 adjustable_params:
| 参数 | 它打开的问题 |
|---|---|
mode (rule\|llm\|hybrid) |
这个家族存在的那个问题:LLM 的 f 能复现规则 f 的不平等曲线吗?hybrid 则把两类人群混在一起。 |
n_steps |
30 步对于 Gini 收敛而言偏短;任务自己的默认配置跑得更久。 |
seed |
rule 与 llm 之间的差距里,有多少只是种子噪声? |
网格尺寸 / n_citizens |
密度是饥饿压力的主要驱动。 |
| vision / metabolism 区间 | 经典 Sugarscape 里决定「谁活下来、谁积累财富」的杠杆。 |
regrowth |
稀缺 vs 丰裕——对「不平等是否出现」影响最强的单一杠杆。 |
十个同族研究(abm_schelling、abm_sir、abm_boids、abm_nasch、
abm_social_force、abm_lux_marchesi、abm_minority_game、abm_axelrod、
abm_civil_violence、abm_hegselmann_krause)采用完全相同的「壳 + umbrella」
形态,所以你在这一个上学到的 fork 方法可以直接搬过去。