药品集采 —— 一个「运行发生在别处」的 study
studies/drug_procurement/ · reference: true · 外部 MARL 管线
(AgentProcure)
政府、企业与医院的策略如何优化药品集中采购(集采)的博弈策略?案例取自中国
第二批国家集采中的一个采购博弈单元:阿德福韦酯片(drug_68)、round 2、
三家竞标企业。但这一页存在的理由不是药品本身,而是那个机制:一个真正的运行
属于重型外部管线的 study,如何仍然接进同一套产物、同一批 discovery 字段、
同一个 dashboard。 除了训练本身,一切都已经在这里物化好了。
P / E / B
| 是什么 | 来自哪里 | |
|---|---|---|
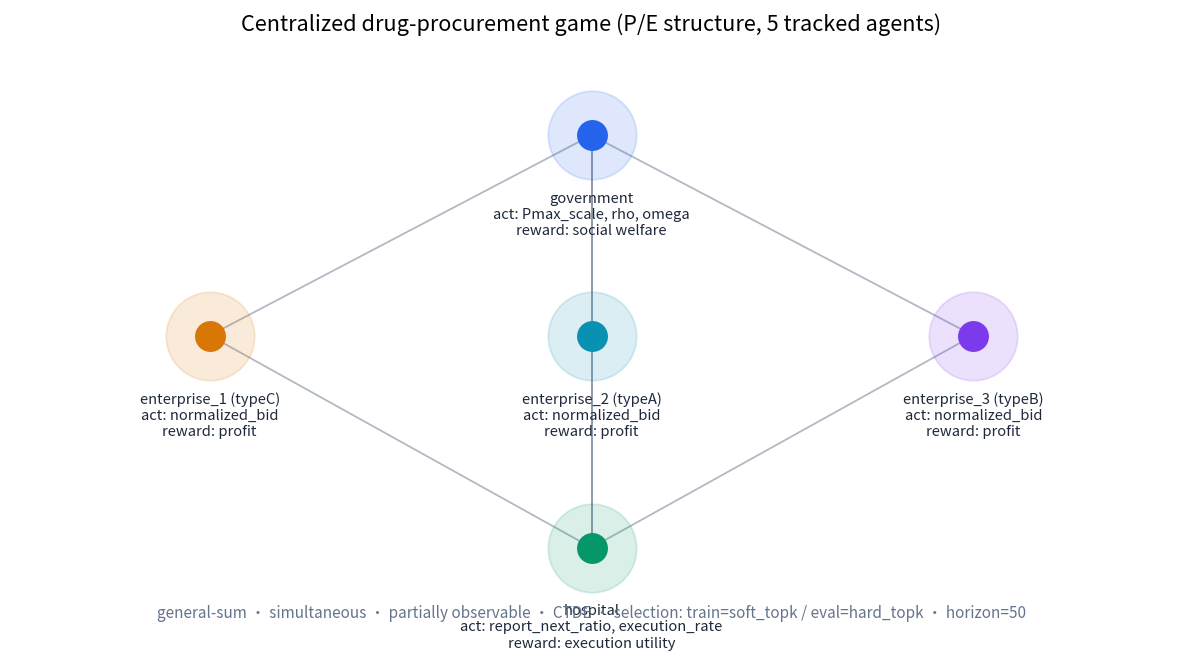
| P | 5 个 agent —— government、hospital、enterprise_1..3,全部 learnable: true 且各有 policy_group。企业属性是本案真实(已脱敏)的工作簿行:共享 Pmax 1.08 元/片、Q0 2893.17、Qe 3471.804,但 beta_i / omega 各异(0.265/0.50、0.470/2.00、0.265/0.50)。交互结构为 explicit_network(政府↔各企业、政府↔医院、医院↔各企业)。 |
population/population.json |
| E | 4 个层,没有 scheduled events、没有 broadcasts —— 外加一个 case-specific 的 game 块。 |
environment/environment.json |
| B | RL 策略,不是 LLM agent。政府 Box(3)(Pmax scale、rho、omega);企业 Box(1)(归一化出价,映射到 (cost_i, Pmax));医院 Box(2)(下期报量比例、执行率)。 |
game 块 + model.py |
| layer | modality | scope | dynamics | 内容 |
|---|---|---|---|---|
policy_variables |
physical | macro | scheduled | 政府侧 Pmax、rho、x、omega |
enterprise_market_state |
physical | local | endogenous | 成本、beta_i、出价、利润、中选状态 |
hospital_execution_state |
physical | local | endogenous | 医院执行 / 报量变量 |
procurement_notice |
information | macro | scheduled | 证据绑定的案例与运行模式说明 |
game 块是本案专属,不属于通用 environment schema
在标准的 layers / scheduled_events / information_program 之外,本研究的
environment.json 还带了一个 game 对象:game_type: general_sum、
timing: simultaneous、observability: partially_observable、
api_target: pettingzoo_parallel、gamma_default: 0.99,以及带类型的 roles、
observations、action spaces、rewards 与终止条件。请把它当作本案的扩展——
其它 study 使用的 environment schema 并不包含它。正是它让一个马尔可夫博弈
能被写进同一份产物里。
三类回报刻意采用三种不同量纲:政府是社会福利(utility)、企业是利润(元)、 医院是执行效用。它们只能分角色读,绝不能求和——这就是 general-sum、 混合动机(mixed-motive)在实操层面的含义。
一步是什么,跑多久
n_steps: 50 是一个采购 episode,而这条轴是训练 episode,不是日历时间。
这是本组案例中最大的一处分野:一步推进的是博弈,而整个 50 步 episode 会在策略
学习过程中被重放成千上万次。
训练配置(simulation/simulation.json):RLlib 上的 PPO、ctde: true、
gamma: 0.99、train_episodes: 10000、eval_episodes: 1000,每个角色一套策略、
每家企业各自一套。中选机制在训练期用 soft_topk(可导、便于学习),在评估期用
hard_topk(最低价中选)——这正是 selection_accuracy 要作为独立指标存在、
而不是被摊进平均回报里的原因。
结果
没有结果——而这正是重点
reports/report.md 明确是一份预运行(setup-only)报告:
0 个训练 episode、0 个评估 episode。没有 trajectory/ 目录,也没有
study.duckdb。外部 AgentProcure 检出及其重型依赖
(pettingzoo / ray[rllib] / gymnasium / torch)未安装在本工作区。
代之交付的,是 study.yaml 上一条双语的 run_note,由工作流呈现给读者:
本案例通过外部 AgentProcure 多智能体强化学习管线运行(ray + torch,重训练 任务)。托管服务里不执行训练——如需真实跑批,请 clone 仓库在本地运行
AgentProcure/run_training.py,再用studies/drug_procurement/adapter/socioverse_export.py导回轨迹。
所以本研究的工作流是:在这里物化 → 到那边训练 → 再导回来。判断这项研究
所需的一切——博弈结构、t=0 roster、grounding 台账、图表——都在花掉任何一个
GPU 小时之前就已提交、可审阅。等训练真的跑了,导出的轨迹落进与其它所有
study 相同形状的 study.duckdb,同一套报告与 dashboard 路径照常适用,四条
display_metrics 为 government_return、enterprise_return、
hospital_return、selection_accuracy。
这份 setup 报告依然给出了发现——因为结构性发现不需要轨迹:人群规模不是随意
选的,而是被「同通用名 ≥3 家生产企业」的纳入门槛锚定;enterprise_2 在
beta_i 与 omega 两个维度上同时偏离,据此可预测两条可分离的策略路径
(高质高成本 vs 低价走量)——待真实运行去证实或证伪。
Grounding
5 条 sourced 事实、1 条 proxy 事实、3 条假设、2 条建模参考——外加一样
catalog 里独此一家的东西:resources.json 内的 evidence[] 数组,承载带类型的
工程证据(PettingZoo parallel API 合约、Gymnasium spaces、RLlib 多智能体策略
映射),每条带 supports[]、confidence、retrieved_at,并由 game 块内的
evidence_ids 引用。
| 条目 | basis | 作用 |
|---|---|---|
| 纳入门槛:同通用名 ≥3 家生产企业(国家医保局) | sourced |
钉住 role_counts.enterprise = 3 与 n_applicants = 3 |
| 中选药品平均降价 53% | sourced |
学习到的出价可以多激进的经验包络 |
| 单品种最高降价 93% | sourced |
该包络的上沿 |
| 本批 32 品种 / 100 产品中选 | sourced |
范围说明:本研究只是这一批里的一格 |
| 中选结果 2020-04 落地执行 | sourced |
把 round 2 锚定在 2020-01 开标 / 2020-04 执行的周期上 |
| 阿德福韦酯属于第二批集采品种 | proxy |
药品身份与定性价格水平来自行业媒体汇总;未找到该具体中选价的官方公告 |
| 企业成本 / 弹性 / 质量参数取自匿名化工作簿 | assumed |
真实投标成本不公开;这些数值是 simulator 输入,不是关于真实企业的事实主张 |
以单一 drug_68 × round 2 作为示范格 |
assumed |
要的是一个完整可读的博弈,而非全批次全景 |
| 结果只能解读为 simulator 内的配对差异 | assumed |
三条里最强的一条:不得据此得出真实世界的因果政策结论 |
这是整个 catalog 里最清晰的一个 basis: proxy
sourced 表示有权威来源直接陈述该数值;assumed 表示没人陈述,研究自行
声明了选择。proxy 是人们通常会略过的中间态:主张有支撑,但支撑物的
证据位阶更低——这里是行业报道代替官方公告。把它如实记为 proxy 而不是
悄悄升格成 sourced,一整套纪律就浓缩在这一个字段里。见
真实世界锚定与溯源。
另外请注意第三条假设约束的是解读,而不只是输入。一个 study 可以在声明 自己常数的同一份台账里,一并声明自己结论的边界。
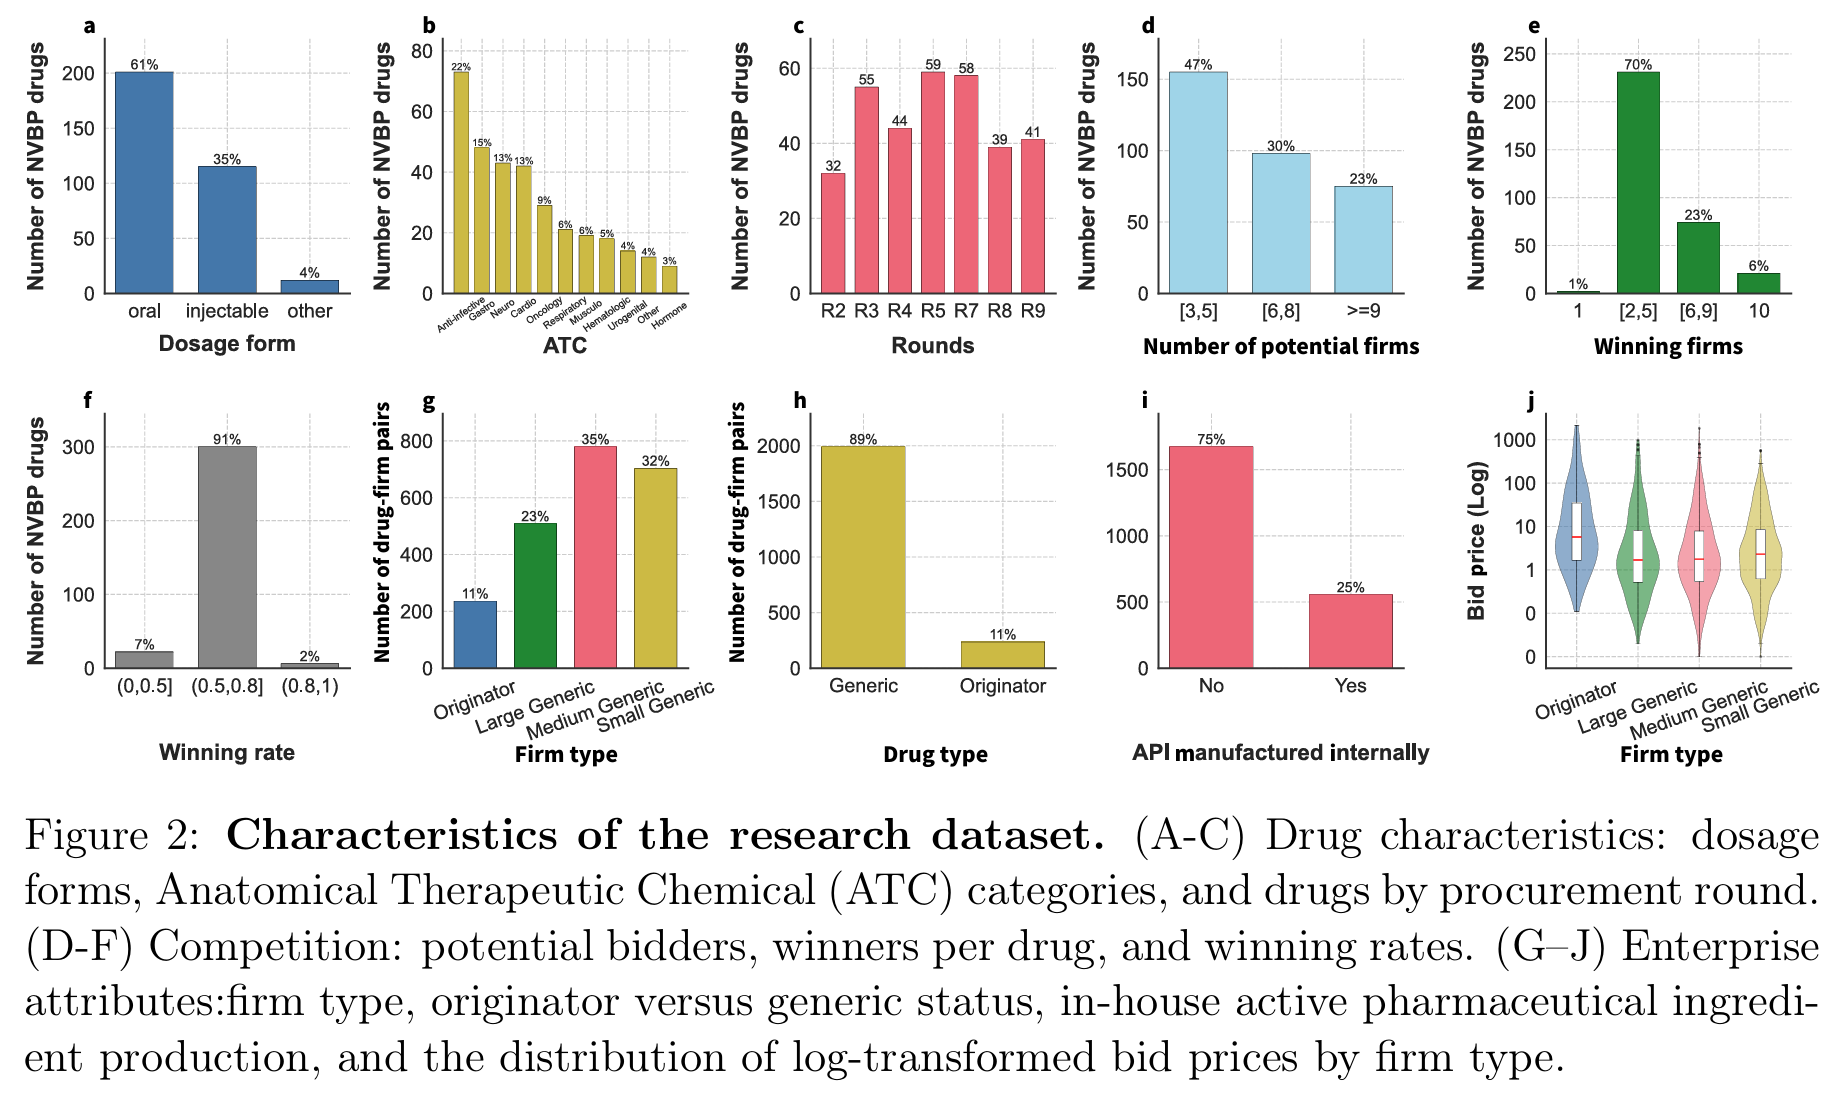
这个单一案例背后是大得多的研究数据集 —— AgentProcure 项目覆盖数百个集采品种、
多轮次、多企业类型与中标结果的 NVBP 语料,drug_id / round_id / focus_drugs
选的正是其中一格:
可以 fork 什么
| 参数 | 它打开的问题 |
|---|---|
drug_id |
同一套博弈机器换一个品种——企业异质性的结构在不同药品间是否相似? |
round_id |
同一品种跨采购批次。 |
timestep |
在 50 步 episode 的哪个位置切片。 |
focus_drugs |
从单格博弈扩成多格对比。 |
data_path |
让案例解析器指向另一个工作簿。 |
shock_id |
反事实轴——见下。 |
--shock-id all 会跑 15 个反事实情景:6 个企业成本冲击
(enterprise_cost_down__cost_scale_{1p5,1p2,1p1,0p9,0p8,0p5})、6 个医院需求
冲击(hospital_demand_up__q0_scale_{…},同样六个系数)、3 个政府单一中选
情景(gov_single_winner__single_winner_x_{1,2,3})。最后一组是最直接的机制
设计实验:当中选家数变化时,三方回报各自怎么动?其中每一个结果都必须读作
simulator 内的配对差异——这条限制写在 grounding 台账里,不是脚注。