快速开始
驱动 SocioVerse 有两种方式,产物与可查询的输出完全一致:
- Agentic 方式(推荐)—— 用 Claude Code
打开仓库,让内置的
sv-*工作流 skill 把你从研究问题带到报告, 每个阶段都停下来等你审阅。 - 编程方式 —— 用 Python API 自己装配研究目录并运行。
先跑一遍离线演示
刚装好的话,python scripts/demo_offline.py 会在不需要 API key 的情况下把一个完整研究
(opinion_diffusion 模板)端到端跑完,python dashboard/server/app.py --open 则在本地
仪表盘里展示它。见安装。
路径 1 —— agentic 工作流
用 Claude Code 把仓库目录(SocioVerse2/,即你 clone 下来的根目录)作为项目打开,
新开一个会话(skill 在会话启动时被发现),然后从你的问题开始:
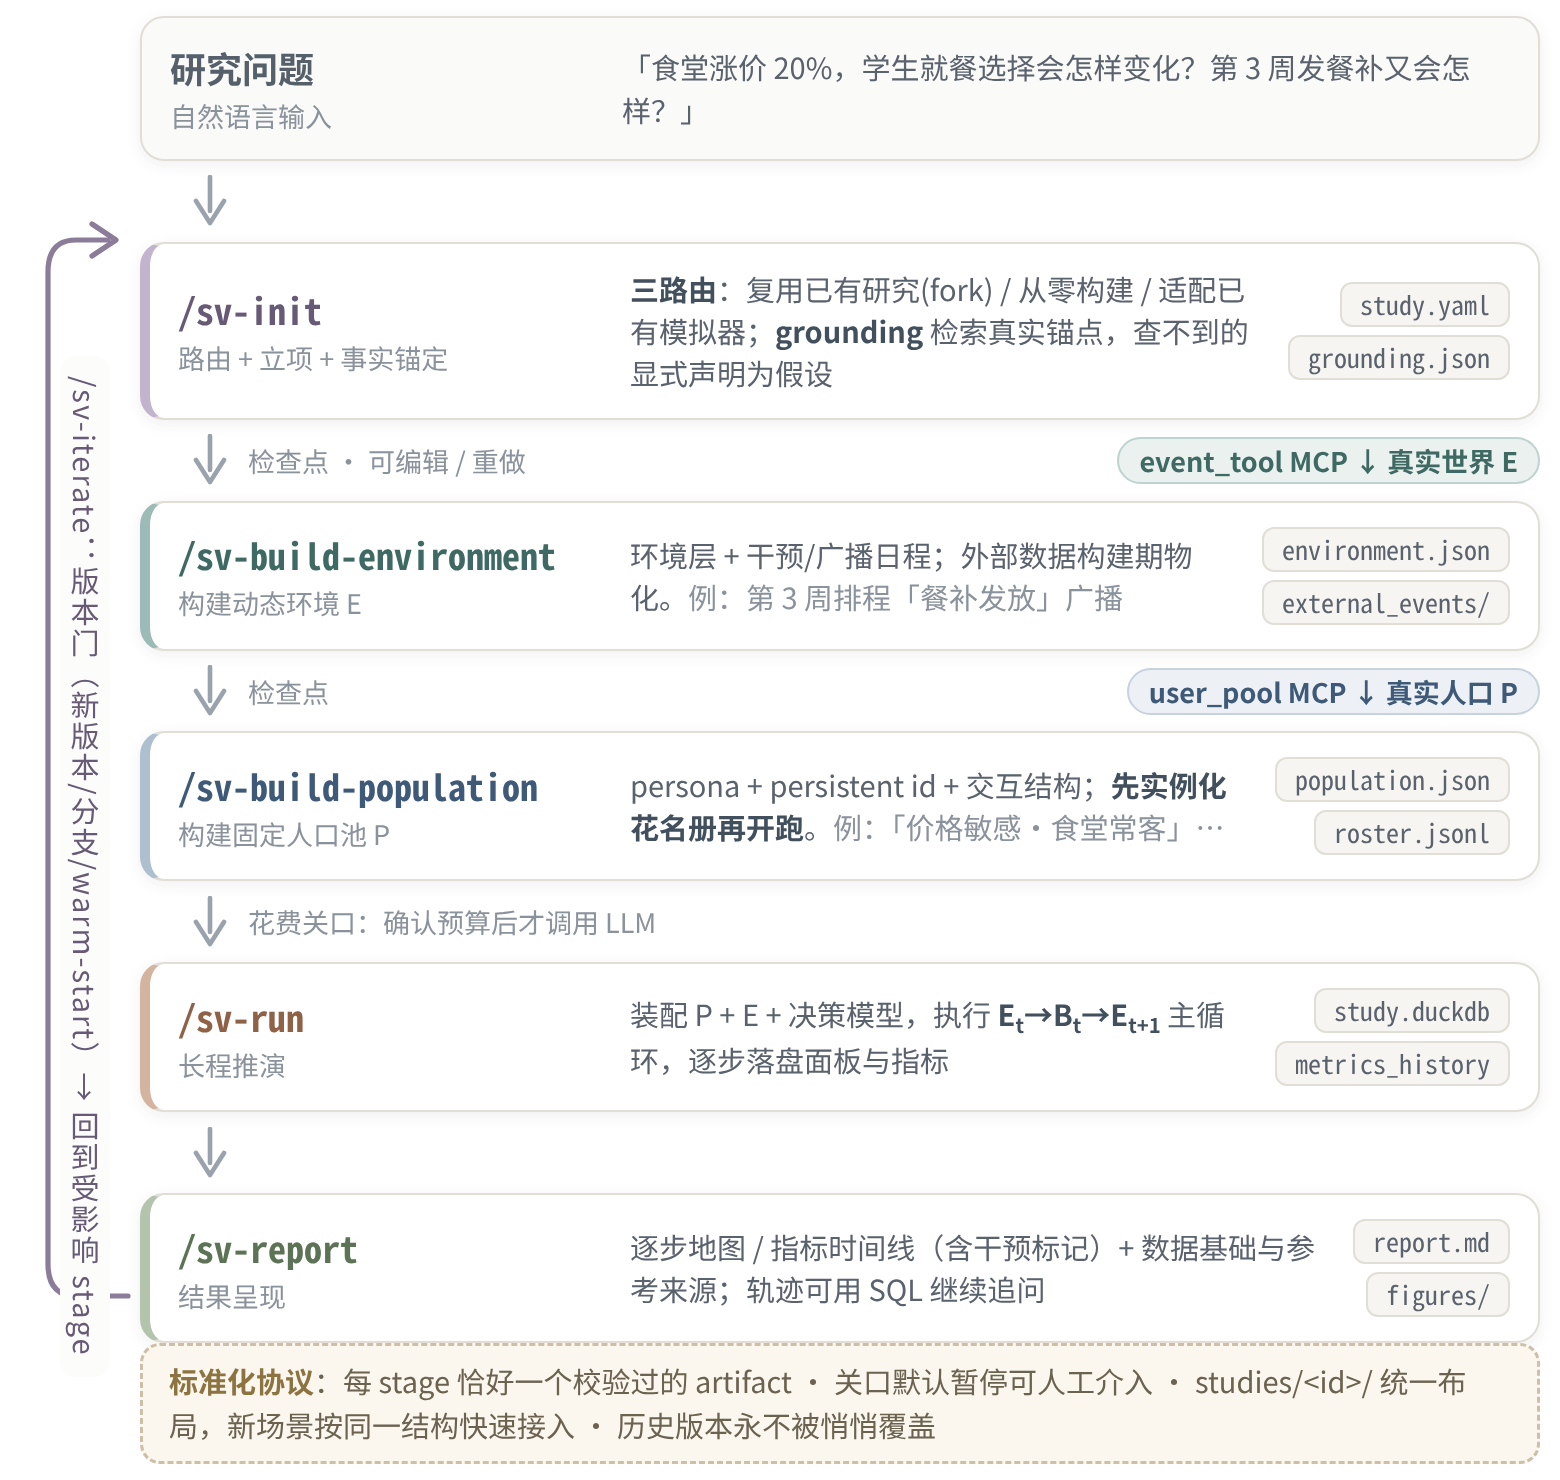
sv-init 会先把你的问题路由到已有研究目录(catalog)上做匹配,
再在 studies/<id>/ 下搭建新研究的骨架。此后每个 skill 只写
一份经 schema 校验的产物,并暂停等你检查或修改:
| 阶段 | skill | 写出 |
|---|---|---|
| 路由与立项 | /sv-init |
study.yaml + grounding/grounding.json |
| 模型 (仅从零构建路径) | /sv-build-model |
model.py |
| 环境 E | /sv-build-environment |
environment/environment.json |
| 人群 P | /sv-build-population |
population/population.json + population/roster.jsonl |
| 运行 | /sv-run |
trajectory/study.duckdb + metrics_history.json |
| 报告 | /sv-report |
reports/report.md + 图表 |
| 后续修改 | /sv-iterate |
versions.json + versions/vN/ 快照 |
节奏由你控制:说「全部构建好,跑 /sv-run 之前问我」或
「整条流水线一路跑完」都可以——每份产物仍会在经过时呈现给你。
两套 LLM 连接
Claude Code 用它自己的 Claude 登录(或 ANTHROPIC_API_KEY)运行;.env 里的
SV_LLM_* key 驱动不了它,只用于模拟中的 agent。没有 SV_LLM_* key 时,从零构建的
研究仍能在 scripted 模式下完整跑通,/sv-run 在花费真实 LLM 调用之前会先询问。
用 Codex CLI(AGENTS.md + .codex/skills/)驱动同一套 skill 属于实验性。见
工作流 skill 由什么驱动。
路由:复用、新建、还是包装
写任何代码之前,sv-init 先在三条路径中做选择:
- Path A —— 复用/调整:已有研究覆盖了你的问题 → fork 出一个新
study_id,只改 fork 的产物。不写新代码。 - Path B —— 从零构建:没有匹配 →
/sv-build-model原生实现四个核心 接口。新问题的默认路径。 - Path C —— 包装你自己的模拟器:见 包装既有模拟器。
检查每一步产出了什么
每个阶段的输出都是 studies/<id>/ 下的普通文件:
S=studies/<your-study-id>
cat $S/study.yaml                    # StudySpec:研究问题、n_steps、指标
cat $S/environment/environment.json  # E:层 + 定时事件 + 广播
cat $S/population/population.json    # P:personas、规模、交互结构
cat $S/population/roster.jsonl       # 实例化后的 agent 在 t=0 的状态
cat $S/reports/report.md             # 渲染出的轨迹 + 干预注记
路径 2 —— 编程方式
一个研究目录就是数据(经校验的 JSON 产物),加上——对从零构建的研究——
一个在 import 时自注册的 model.py。装配一次运行只需四次校验加载和一个调用:
import studies.your_study  # noqa: F401 —— 副作用:@register() 生效
                           # (随仓库提供的模板是 studies/opinion_diffusion)

from socioverse.engine import build_simulator
from socioverse.validation import validate_handoff
from socioverse.schemas import EnvironmentBundle, PopulationBundle, SimulationConfig

S = "studies/your_study"
env_b   = validate_handoff(f"{S}/environment/environment.json", EnvironmentBundle)
pop_b   = validate_handoff(f"{S}/population/population.json",  PopulationBundle)
sim_cfg = validate_handoff(f"{S}/simulation/simulation.json",  SimulationConfig)

sim = build_simulator(
    env_bundle=env_b, pop_bundle=pop_b, sim_config=sim_cfg,
    store_path=f"{S}/trajectory/study.duckdb",
)
history = sim.run()   # E_t → B_t → E_{t+1};面板与指标落入 DuckDB
build_simulator 会把产物里的 *_ref 字符串在
registry 中解析,
返回就绪的 LongitudinalSimulator;run() 返回 MetricsHistory。
无 token 干跑(零 LLM 花费、确定性):在研究的 decision_args 里设
"llm_kind": "scripted",见 LLM 接入与干跑。
只装了库?socioverse.* 用 pip install socioverse2 就够
PyPI 包提供的是 socioverse 库。上面 import 的 studies.* 模块(你自己的研究或
参考研究)在仓库检出里,所以请在 clone 下来的仓库里运行,或者把你自己的研究包放进
Python 路径。
读取结果
运行结果落在一个持久化的 DuckDB 存储里,可直接查询:
-- 单个 agent 的时间线(纵向视角)
SELECT step, state FROM panel WHERE agent_id = '…' ORDER BY step;

-- 聚合轨迹
SELECT * FROM metrics ORDER BY step;

-- 哪些干预在何时触发
SELECT step, note FROM events ORDER BY step;
在 Python 里用 duckdb.connect(path, read_only=True) 能拿到同样的表。
接下来
- 理解模型:总览 — B = f(P, E)
- 研究目录里有什么:一个 Study 的解剖
- 构建你自己的研究:从零构建 Study