外部能力
一切不是仓库内代码的东西——事件 API、真实 persona 池——都是声明式的能力, 而不是藏起来的接线。能力统一收录在一个提交入库的公开文件里;端点和 key 住在 完全另一个地方;每个研究按名字记录自己实际用过哪些。
能力注册表
resources/capabilities.yaml 是那份公开索引。它被刻意提交入库、开源:一个条目
宣告某个能力存在、什么时候该用它、以及没有它时怎么继续走。
| 字段 | 含义 |
|---|---|
name |
唯一 id。kind: mcp 时它必须等于 .mcp.json 里的 server 名 |
kind |
mcp | http_client | builtin |
provides |
一行话:它给研究带来什么 |
stages |
哪些 sv-* skill 会咨询它(capability_view 按此过滤) |
use_when |
skill 拿研究去比对的触发条件 |
confirm |
true = 调用会花掉协作者的预算、或把数据发出去 → 先征求同意 |
cost |
计费方式(见下面的辨析) |
available_when |
静态可用性检查:{mcp_server: <name>} 或 {env: [VARS…]} |
health |
真正依赖它之前要跑的实时探针 |
howto |
skill 怎么用它,含物化与溯源规则 |
fallback |
不可用时怎么办——离线 / 开源路径 |
attach |
有访问权的人如何注册那个私有端点 |
构建 skill 通过 skills.sv_workspace.capability_view(stage=…) 读它:原样返回
每个条目,再加两个解析出来的字段:
| 解析字段 | 类型 | 含义 |
|---|---|---|
available |
bool |
在当前环境里 available_when 是否通过 |
availability_note |
str |
原因——比如缺哪个环境变量、缺哪个 MCP server |
confirm 和 cost 是两个不同的信号
confirm: true 表示这次调用会花掉协作者的预算或把数据发出去,所以工作流
要停下来问。cost 描述的是计费。两者互相独立。内置的 event_tool 是
confirm: false 并且有成本:它便宜、只读,所以工作流直接用、在阶段闸门处
汇报——但在托管服务上,每一次抓取仍然计入你的配额。不要把
confirm: false 读成「免费」。
每个条目都遵守三条不变量:
- 端点和 key 永不进注册表。
kind: mcp通过 gitignore 的.mcp.json解析,kind: http_client通过 gitignore 的.env里的环境变量解析。 - 研究在自己的
resources.json里按名字(NAME)钉住用过的能力 (McpServerDecl)——可复现的溯源,私有端点不会漏进提交的产物。 - 接入一个新服务 = 加一条注册表条目、零 skill 修改。 每个 skill 只带一个 稳定、通用的能力检查钩子;skill 正文里从不出现某个具体服务的名字。
配置服务:.env 是唯一来源
服务 key 只住在一个 gitignore 的文件里:socioverse-beta/.env
(从 .env.example 起步)。.mcp.json 是由它生成的:
生成脚本读 SV_EVENT_API_URL / SV_EVENT_API_KEY 和
SV_USER_POOL_MCP_URL / SV_USER_POOL_MCP_KEY,写出对应的 mcpServers 条目。
改 .env、重跑脚本——不要手改 .mcp.json,两个文件都不要提交。安装路径见
安装。
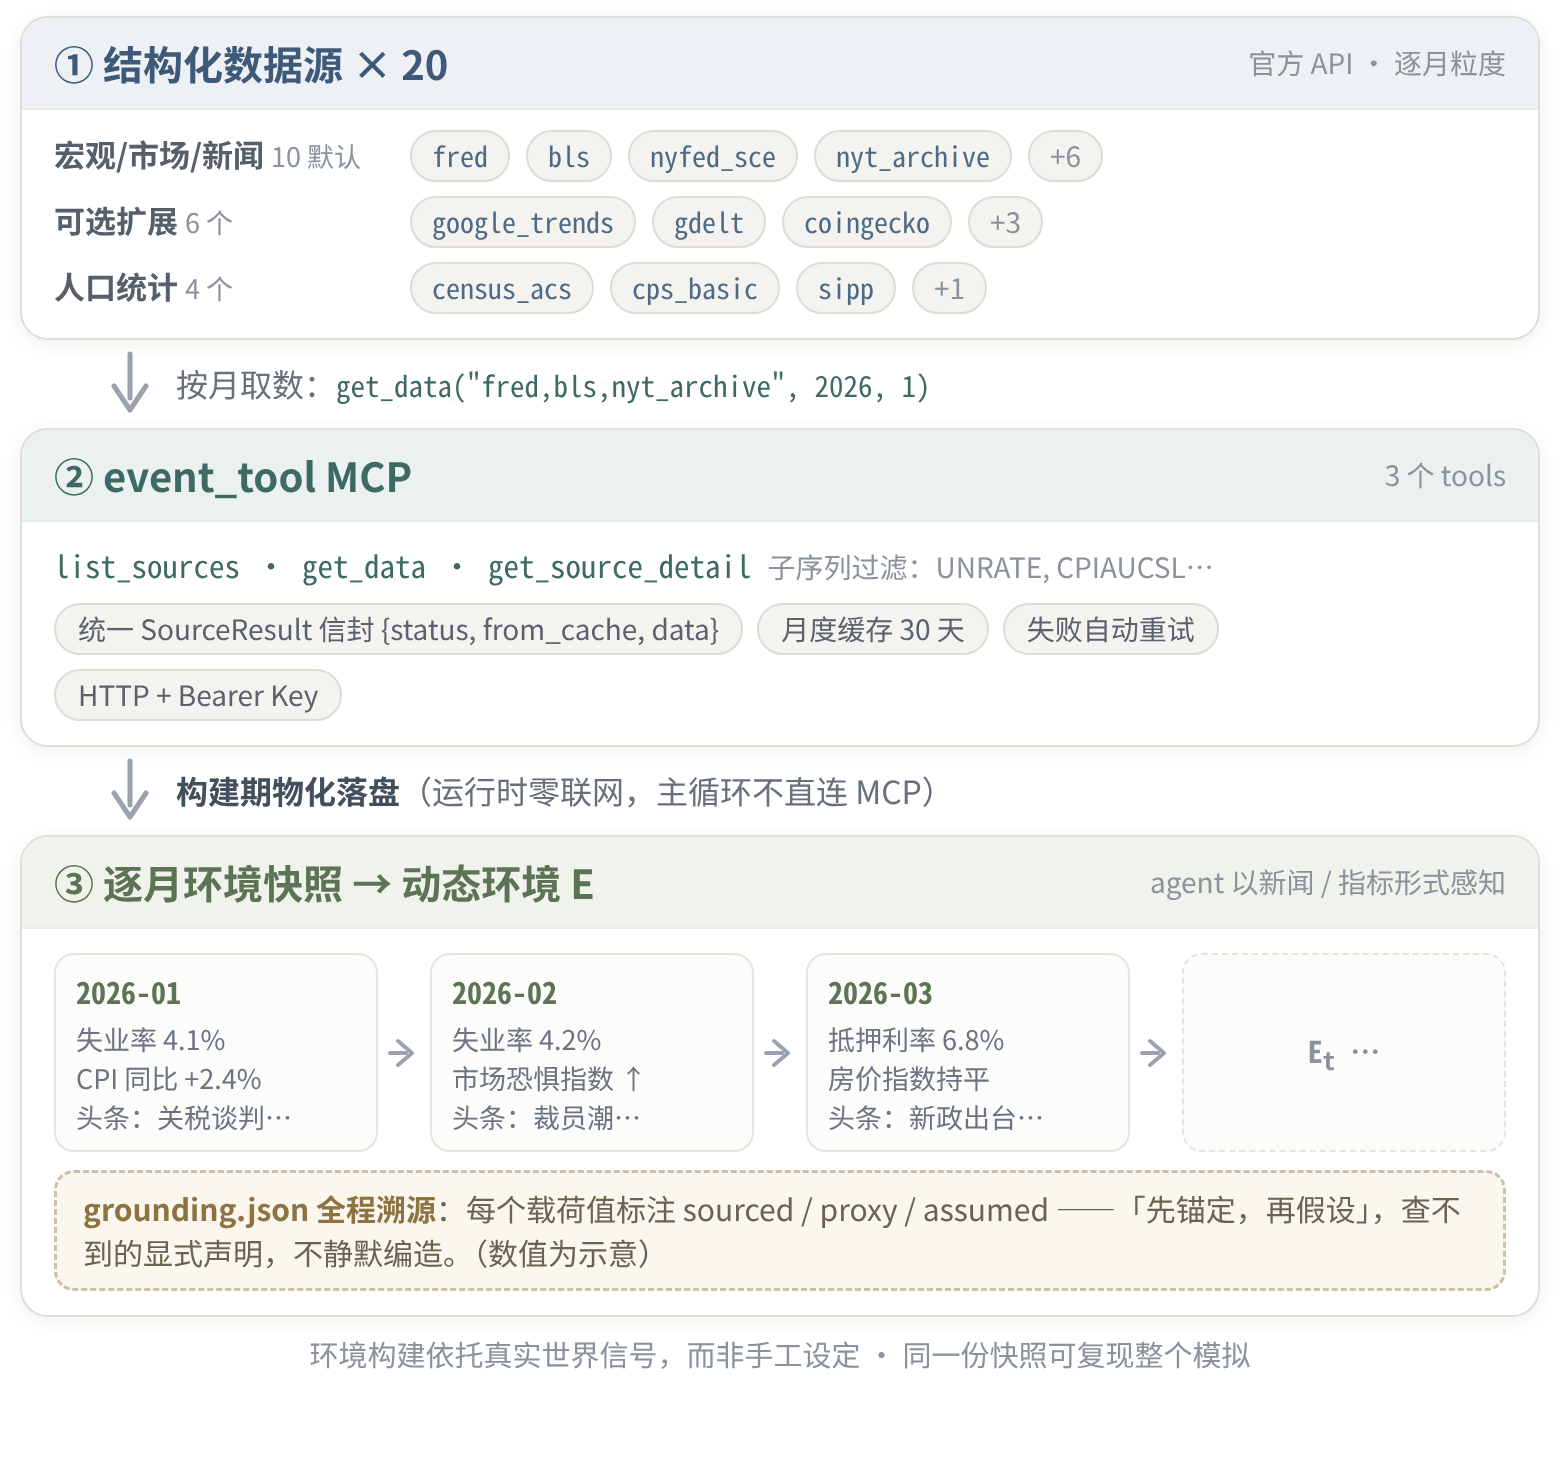
event_tool——给 E 的真实世界事件与宏观背景
| kind | http_client |
| stages | sv-init、sv-build-environment |
| provides | 给 E 的结构化宏观 / 新闻 / 市场背景(FRED、census、逐月新闻归档) |
confirm |
false——但计费,见上面的辨析 |
| 配置 | SV_EVENT_API_URL、SV_EVENT_API_KEY,可选 SV_EVENT_LOCAL_CACHE |
sv-init 的 grounding 引导会把结构化事实推迟给这个服务;
sv-build-environment 把它们物化进研究。
三个最常踩错的点
SV_EVENT_API_URL是完整的 MCP 端点,含路径——例如http://host:9997/event_mcp,不是裸主机名。生产服务在 MCP 线路上说 JSON-RPC(tools/call get_data),带Authorization: Bearer头。不需要 MCP SDK。- 健康探针在主机根路径
/healthz,不在 MCP 路径下。客户端会先探它 并 fail-fast,然后才逐 source 抓取。 months=是必填的。 生产服务没有 query 解析器(agent 层是被刻意去掉 的)。永远显式传months=列表,通常也传sources=。query只用于溯源。
API
from socioverse import materialize_external_events, month_range

path, ev = materialize_external_events(
    study_dir,
    query="US inflation and consumer sentiment, 2024",   # 仅用于溯源
    months=month_range("2024-01", "2024-12"),            # 必填
    sources=["fred", "nyt"],
)
materialize_external_events(...) 写出 environment/external_events.json,
返回 (path, bundle)。month_range(start, end) 生成闭区间的 "YYYY-MM" 列表
(上限 48 个月)。
值得记住的 bundle 字段:
| 字段 | 含义 |
|---|---|
provider |
remote | local_cache | unavailable |
available |
property:provider != "unavailable" |
results |
数据本体,键为 "<source>_<YYYY-MM>" |
requested_months / requested_sources |
你请求了什么 |
errors |
每一层的失败记录——降级发生时读它 |
summary、web_evidence |
遗留字段。不要据此撰写内容。 |
广播只能写自 ev.results,绝不能写自 ev.summary
summary(以及 web_evidence)装的是另一个模型写的散文。把那段文字注入
E,意味着你观察到的行为部分是在回应第三方 LLM 对世界的表述,而不是在回应
世界本身——它污染了 B = f(P, E) 的归因,悄悄让整个研究失效。请从
ev.results 里读出结构化数字,广播由你自己撰写。
降级链
客户端逐层降级,且永不抛异常:
- remote——事件服务,前提是配了
SV_EVENT_API_URL且/healthz正常; - local_cache——
SV_EVENT_LOCAL_CACHE,目录布局<source>/<YYYY-MM>.json,离线用; - unavailable——此时你就是第三层:手工网络检索、手写广播,并把每一个
数字都记进 grounding 侧车,
via="web_search",附 url 与访问日期。
没有事件服务的研究同样是有锚定的——台账只是如实记录更朴素的依据。这些事实怎么 记录,见真实世界锚定与溯源。
user_pool_survey_mcp——给 P 的真实平台 persona
| kind | mcp |
| stages | sv-build-population、sv-report |
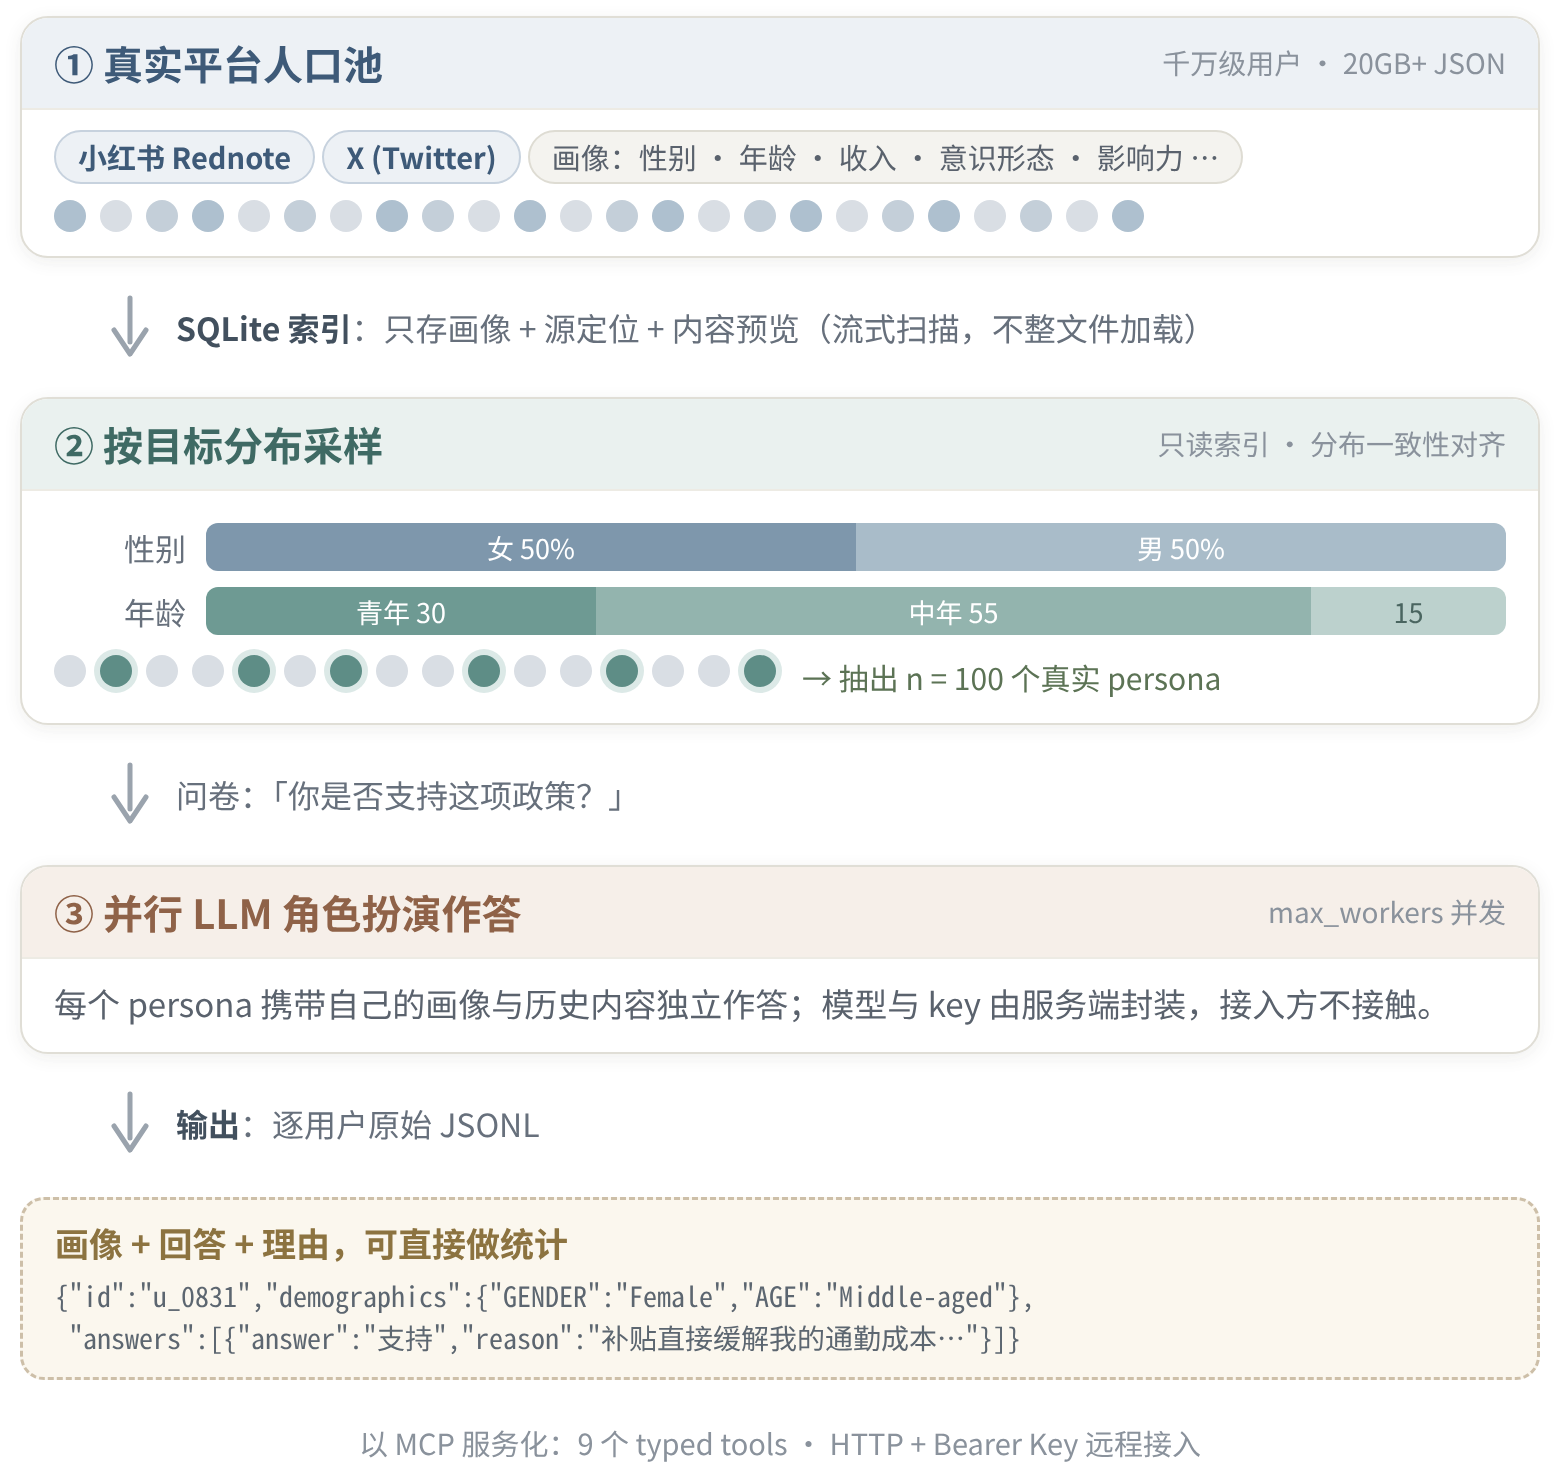
| provides | 按目标边缘分布采样的真实 X/Twitter 与小红书 persona,外加基于它们的 LLM 问卷作答 |
confirm |
true——每次调用都花掉协作者的 LLM 预算,并把问卷发出去 |
| 配置 | SV_USER_POOL_MCP_URL + SV_USER_POOL_MCP_KEY(bearer 鉴权)→ .mcp.json |
当 P 应当锚定在真实平台用户上(而不是合成出来的),或者研究想在纵向面板旁边 再要一份横截面问卷基线时,用它。
仅限构建时,通过会话内的 MCP 工具:
- 先用
get_user_pool_simulation_capabilities做健康检查 (索引状态用get_user_pool_index_status)。 - 调
run_user_pool_distribution_simulation(platform_id, distributions, user_count, questionnaire, seed, max_workers)——max_workers≤ 128。 platform id:x_mode_1(X/Twitter)、rednote_v2(小红书)。
allow_virtual_users 默认为 true
如果某个目标分布格子没有匹配到真实用户,服务会静默地用 VIRTUAL_*
persona 补上。需要真实用户就传 allow_virtual_users=false,并检查返回的
sample 有没有缺口——覆盖不到的格子是关于你人群的一项发现,不是要糊过去的
麻烦。
物化返回结果:
- 把返回的
output_jsonl写进population/产物(personas + roster),P 侧接缝用provider_ref="mcp.socioverse_pool";或写进报告的基线表; - 每个承重分布记一条 grounding 事实,
via="provider",source = 平台 + 查询; - 把返回的
llm_model留在溯源里——答案是依赖模型的。
成本随 user_count 线性增长
一次分布模拟会为每个被模拟的受访者跑一次 LLM 问卷作答。成本大致是
user_count × 单人费率,在托管服务上计入你的 sim-plane 配额,见
配额与计费。因为 confirm: true,调用前要
说清预计开销(user_count 是多少、会扣余额),拿到明确同意再调。
降级: 按「先锚定再发明」的规则合成 persona(检索到的锚点,或明确声明的
假设),或加载用户上传的文件(provider_ref="file.personas"),并在溯源里注明
persona 池当时不可用。
延伸阅读
- 真实世界锚定与溯源——这些服务产出的事实记在哪
- external events API 参考
- workflow helpers 参考——
capability_view()等 - 托管服务——这些能力在那里已预配置并计费